Module 01: CUDA 与 GPU 硬件基础
涵盖 SM 架构、Warp 原语、Bank Conflict、Occupancy、TMA、Unified Memory 与 CUDA Graph 等 27 道大厂真题全解
深入 NVIDIA GPU 物理极限、指令调度、片上存储层次与 Hopper 架构新特性深度剖析
模块导读:本模块共 27 道 高频面试题。前 2 题为公开免费样题(含完整题目描述与参考解答);第 3 题起的 25 道题目描述全部公开(见下方完整题目列表),答案在构建时加密,凭卡密在浏览器端解密后查阅。
Q1:CUDA 了解吗,写过哪些 Kernel?
Q2:一个 SM 里包含什么?
Tip💡 核心参考解答(公开试读样题)
计算核心 CUDA Cores、Tensor Cores、寄存器、Shared Memory、Warp Scheduler
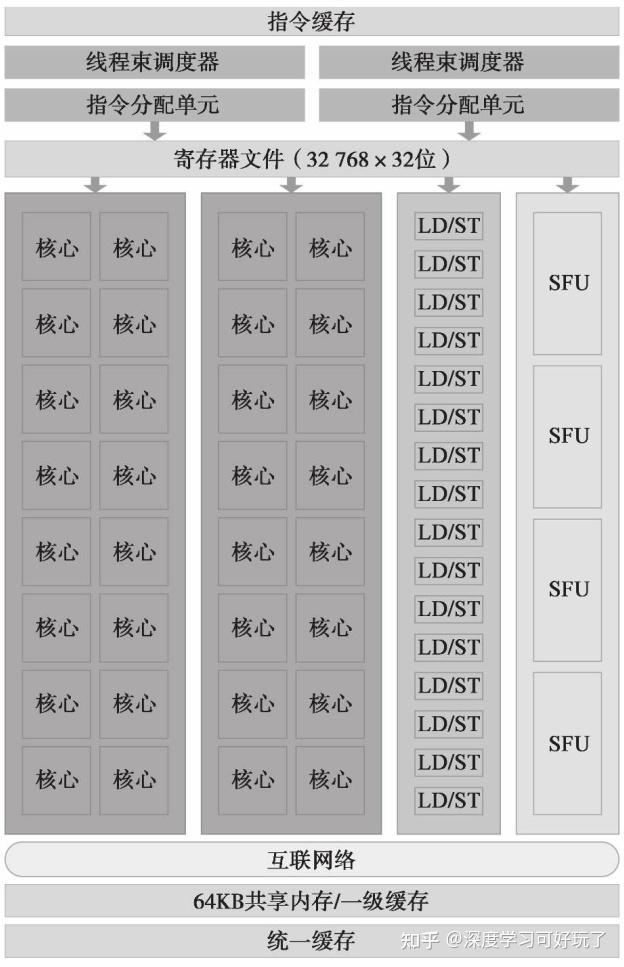
Warp Schedulers & Dispatch Units (Warp 调度器与分发单元): 负责管理和调度 Warp(一组 32 个线程)。它决定下一时刻哪一个 Warp 进入执行单元。
LD/ST Units (Load/Store Units): 负责在内存和寄存器之间搬运数据。
SFU (Special Function Units): 负责处理特殊的数学运算,如正弦(sin)、余弦(cos)、平方根(sqrt)和倒数等
本模块完整题目列表
以下为本模块全部 27 道题目。Q1–Q2 答案公开免费试读,Q3 起的答案需凭卡密解锁(题目描述本身全部公开)。
- CUDA 了解吗,写过哪些 Kernel?(免费)
- 一个 SM 里包含什么?(免费)
- 什么是 Warp Divergence?如何优化
- 介绍下 CUDA 中的 Warp 概念。讲讲跨 Block 的内部通信和 Warp 原语。举一些 Warp 原语的例子,分别是什么作用?
__syncthreads()和__syncwarp()的区别?- 如何计算占有率?限制占有率的三个要素是什么?占有率越高越好吗?
- 了解 GPU 的 CUDA Core 和 Tensor Core 吗?常用的 GPU 有哪些?它们的显存和显存带宽有多大?
- H100 相比 A100 有哪些改进?
- 介绍 NVIDIA GPU 基础概念:Grid, Block, Thread, Warp, L1/Shared Memory, L2 Cache, Global Memory, SRAM/HBM, Tensor Core, TMA 等。
- 讲一下对 NVIDIA 芯片的 PTX 机器模型的认识。
- A100 的理论显存带宽上限是多少?
- Unified Memory (统一内存)
- CUDA 的 Global Memory 和 Shared Memory 访存分别需要注意什么?
- CUDA 编程中 Shared Memory 的 Bank Conflict 是什么?怎么解决?
- 为什么将数据加载到 Shared Memory 计算比直接从 HBM 读取计算更快?
- 为什么 Host 到 Device 的传输建议用 Pinned Memory?
- 将 Ampere 架构的算子适配到 Hopper 架构,需要对哪些地方进行升级改造?
- Hopper TMA (Tensor Memory Accelerator) 的优点、调用方式是什么?是否需要经过 L1 Cache?
- GPU 按列遍历一个行优先矩阵为什么性能差?具体是哪个指标变差?
- 什么是 CUDA Graph?为什么 CUDA Graph 会用到更多的显存?推理的什么阶段更适合使用 CUDA Graph?
- 怎么减少 Launch Kernel Overhead?
- CUDA_DEVICE_MAX_CONNECTIONS 的具体含义是什么?
- cudaStreamNonBlocking 是什么意思?
- CUDA 中的 launch_bounds 是什么含义?
- H2D (Host to Device) 和 D2H (Device to Host) 的数据传输可以重叠吗?如何实现?
- 为什么 cudaMemcpy 异步拷贝时需要使用 Pinned Memory (锁页内存)?
- 讲讲对 CUDA 代码编译流程的认识。
<div class="vip-lock-badge">🔒 VIP 专享核心题库·进阶真题全量加密</div>
<h3 class="vip-module-lock-title">后续 25 道大厂核心真题与手撕源码已锁定</h3>
<p class="vip-module-lock-desc">
  本模块第 3 题起的参考解答(追问细节、白板推导与手撕 Kernel 实现)在构建时加密,凭卡密在浏览器端解密后查阅。上方已公开全部题目列表。
</p>
<div class="vip-module-features">
  <div class="vip-feat-item">✓ 后续 25 道题目的完整参考解答</div>
  <div class="vip-feat-item">✓ 大厂追问细节与白板推导心法</div>
  <div class="vip-feat-item">✓ 手撕 CUDA / Triton Kernel 源码</div>
  <div class="vip-feat-item">✓ 微店自助下单,或闲鱼人工发卡</div>
</div>
<div class="vip-lock-actions">
  <button class="vip-btn vip-btn-primary vip-btn-lg" onclick="window.hpcVip.openModal()">🔑 输入密钥立即解锁后续全部 25 题</button>
  <a href="https://weidian.com/item.html?itemID=7884224812&utm_source=hpclearning&utm_medium=vip_card&utm_campaign=vip_card" target="_blank" class="vip-btn vip-btn-outline vip-btn-lg">🛒 微店下单获取卡密</a>
</div>