本课目标与完成标准
本课产出:实现 ring/tree 的 α-β 粗模型,并解释为什么模型只能筛选、不能替代 nccl-tests。
通过要求:唯一代码填空题通过给定检查;Q1~Q3 都给出因果链;能指出一个正确性边界和一个性能/运营取舍;总分至少 8/10。
与既有六条主线的边界
train/ 已计算通信量;本课把 latency α、带宽 β、消息大小和拓扑 hop 连接到 runtime algorithm 选择。
前置:Python、PyTorch、train 第 1~5 课、CUDA 基础。本课只补 AI Infra 缺口,不重复已经完成的 kernel 或并行算法推导。
核心概念与运行机制
1. 它是什么,解决什么问题
在分布式深度学习(如 DDP 梯度规约、TP 张量并行与 FSDP 全切片)中,集合通信(Collective Communication,尤以 AllReduce 为代表)的耗时直接决定了系统的线性加速比。然而,在大规模 GPU 集群中,通信时延并不是一个静态常数,而是受到报文尺寸(Message Size S S 、通信拓扑(Topology) 与底层通信算法(Ring vs. Tree vs. CollNet) 共同支配的动态物理过程。
为了在万卡集群中科学规划并行切分与算子重叠,AI Infra 工程师必须建立严格量化的集合通信成本模型(Communication Cost Model) :
α \alpha β \beta 固有启动延迟 α \alpha ,以及受物理信道吞吐制约的传输每字节反向带宽 β = 1 / B \beta = 1/B ;
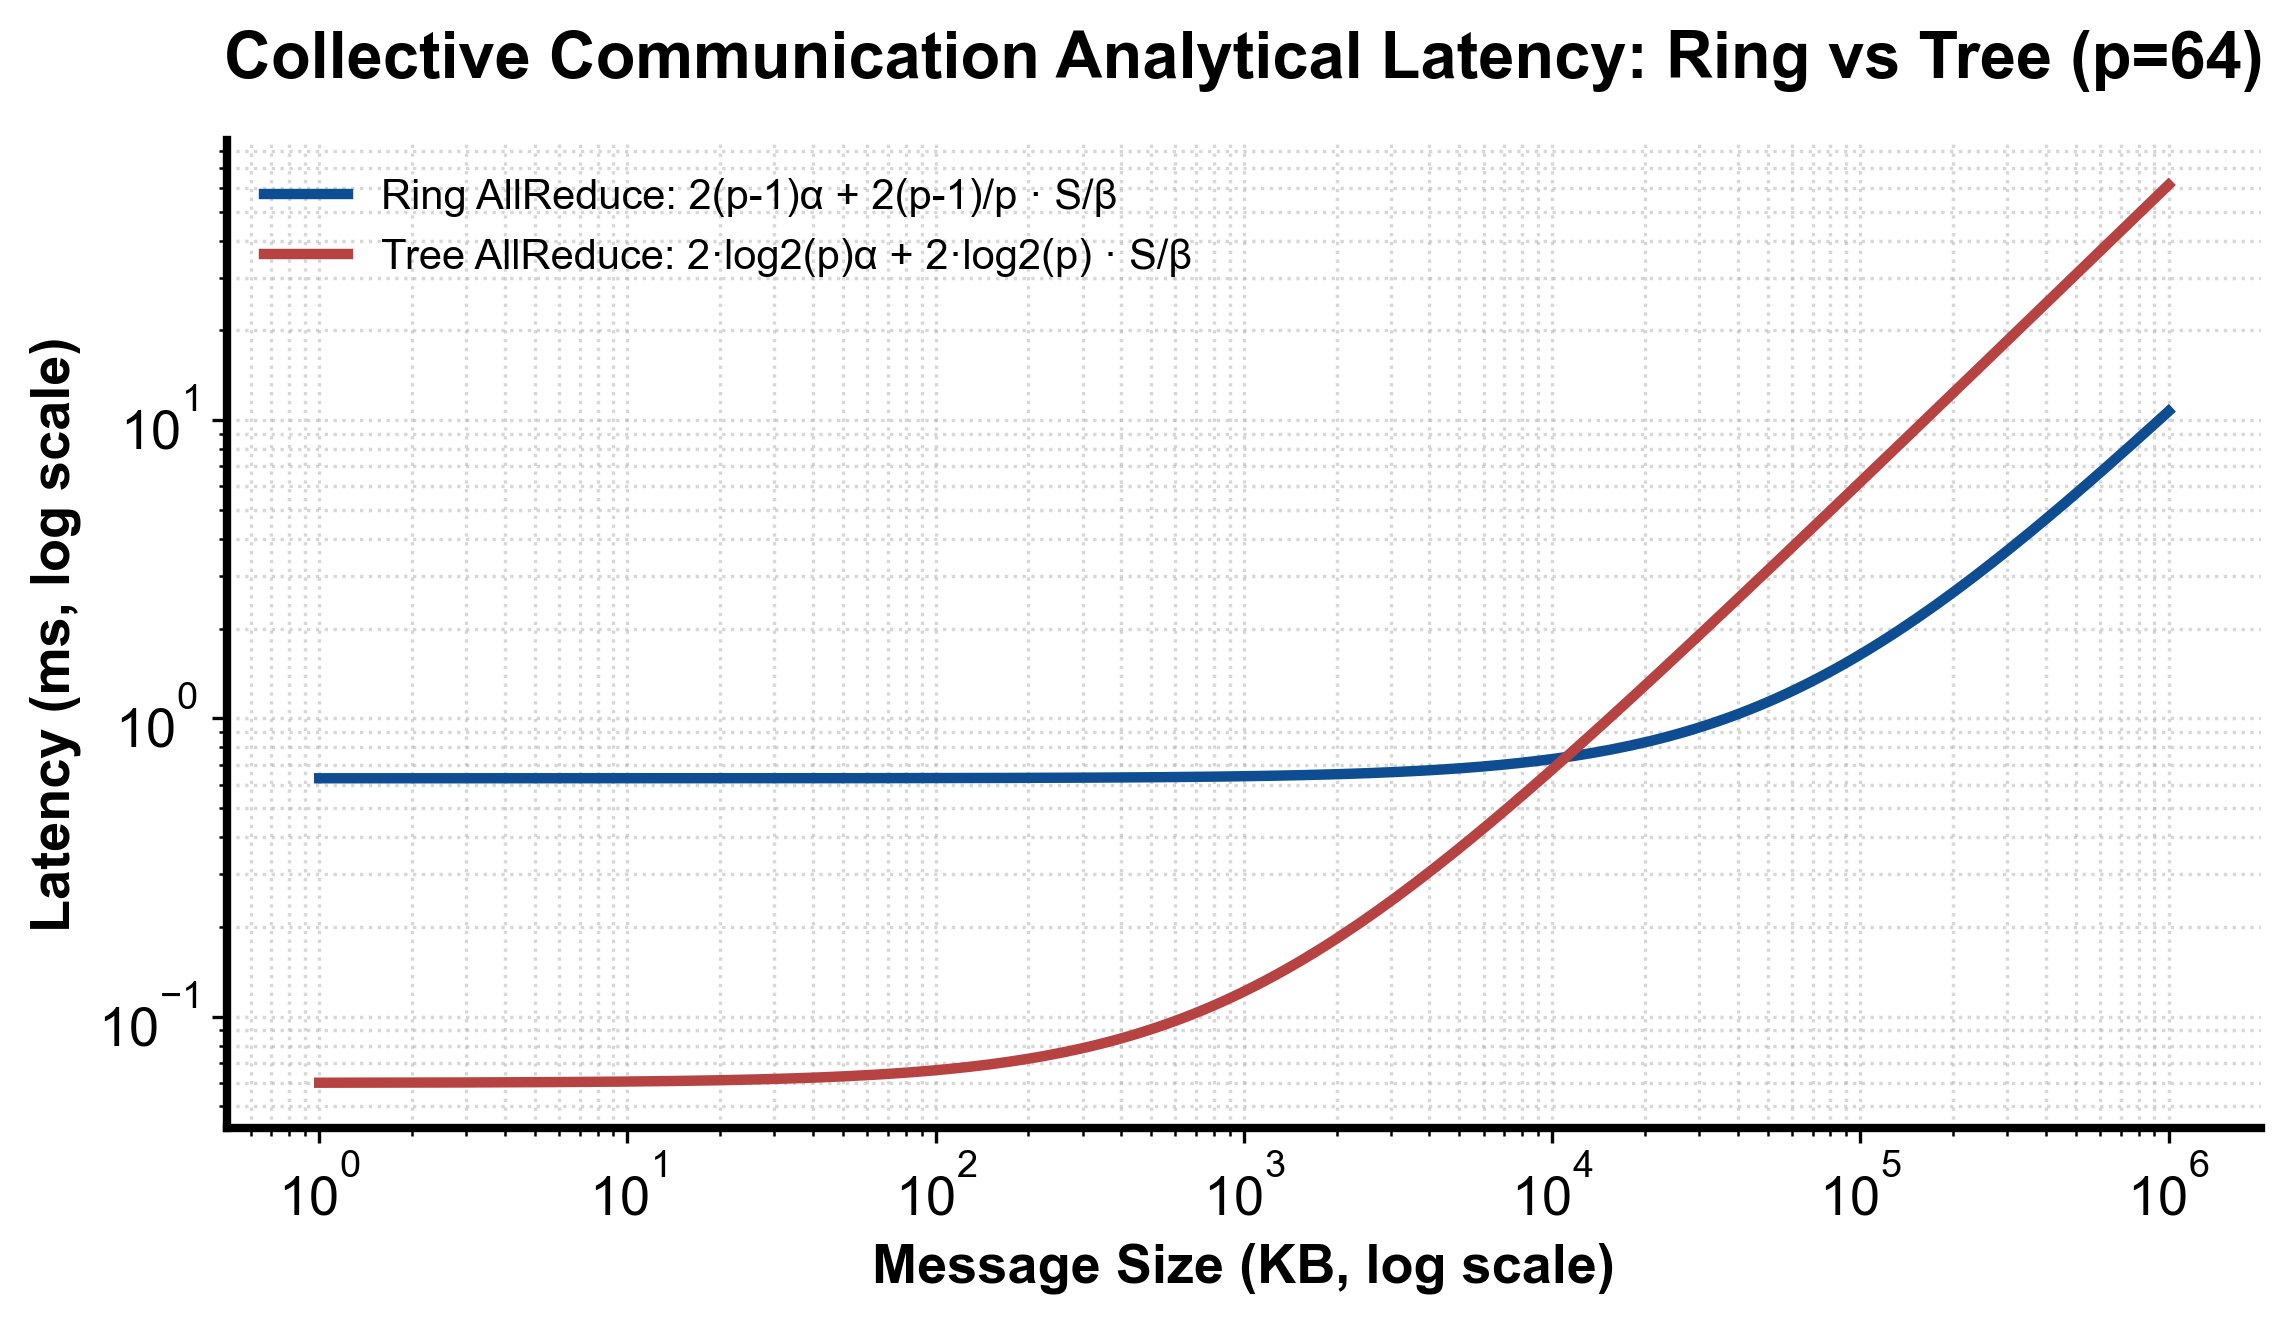
解决算法选型黑盒问题 :如图 4-1 所示,
图 4-1:Ring 与 Tree 集合通信算法理论时延模型与报文尺度分界
没有一种集合通信算法在所有场景下均占统治地位。Tree 算法以 𝒪 ( log p ) \mathcal{O}(\log p) 100 % 100\%
分层异构路由决策 :如图 4-2 所示,
选择 Tree / CollNet 算法 (极小化延迟 α)
选择 Ring 环形切分流水 (极大化总线带宽利用率 β)
跨机网络是否支持 NVLink + RoCE 异构层次?
启用分层规约: 节点内 NVLink 规约 -> 节点间跨机网络 -> 节点内广播
S 较小 (小包) S 较大 (大张量) 支持
图 4-2:通信报文尺度判定与层次化集合通信算法路由决策流
指导 NCCL 在节点内高带宽 NVLink 与节点间跨机网络(InfiniBand / RoCE)之间自适应选择最优的层次化通信拓扑。
2. 它如何工作
集合通信的成本建模与拓扑选择建立在严格的数学推导之上(模型对比如图 4-1,决策流如图 4-2):
Ring AllReduce 成本推导 :
将待传输的 S S p p
算法分为两阶段:ReduceScatter(环形分块累加) 与 AllGather(环形分块广播) ;
每阶段均执行 p − 1 p - 1 S p \frac{S}{p}
总耗时模型为: T ring ( S , p ) = 2 ( p − 1 ) α + 2 ( p − 1 p ) S B ring T_{\text{ring}}(S, p) = 2(p - 1)\alpha + 2\left(\frac{p - 1}{p}\right)\frac{S}{B_{\text{ring}}}
物理特性 :当集群卡数 p ≫ 1 p \gg 1 p − 1 p → 1 \frac{p-1}{p} \to 1 2 S / B ring 2S / B_{\text{ring}} 带宽成本与节点数完全解耦 。但其延迟项 2 ( p − 1 ) α 2(p-1)\alpha Tree AllReduce 成本推导(朴素、非流水线树模型) :
节点组织为逻辑二叉树或二项式树(Binomial Tree),分为树根归约与树叶下发两阶段,且每层要等整条报文收齐后才向下一层转发;
树的最大深度为 ⌈ log 2 p ⌉ \lceil \log_2 p \rceil
总耗时模型为: T tree ( S , p ) = 2 ⌈ log 2 p ⌉ α + 2 ⌈ log 2 p ⌉ S B tree T_{\text{tree}}(S, p) = 2\lceil\log_2 p\rceil \alpha + 2\lceil\log_2 p\rceil \frac{S}{B_{\text{tree}}}
物理特性 :延迟项仅为 2 log 2 p ⋅ α 2\log_2 p \cdot \alpha log 2 p \log_2 p 注意 :log 2 p \log_2 p 2 S / B 2S/B 报文分界与分层拓扑路由(图 4-2) :
求解两条曲线的理论交叉阈值点 S * S^* S * = 2 ( p − 1 − log 2 p ) α 2 log 2 p / B tree − 2 ( p − 1 ) / ( p ⋅ B ring ) S^* = \frac{2(p - 1 - \log_2 p)\alpha}{2\log_2 p / B_{\text{tree}} - 2(p-1)/(p \cdot B_{\text{ring}})}
当 S < S * S < S^*
当 S > S * S > S^*
面对跨机异构网络,NCCL 的 Ring 和 Tree 并不是“节点内 ReduceScatter → 跨机 AllReduce → 节点内 AllGather”的三段式:Ring 把节点内 NVLink 路径与跨机网卡串成一个全局环,Tree 在节点内走链、跨机走双二叉树。显式的 两级分层规约(Hierarchical / Two-Level AllReduce) 是 NVLS、CollNet 或 Horovod 风格分层实现采用的方式:节点内先做 ReduceScatter,各卡只把自己负责的分片送上跨机网络做 AllReduce,最后节点内 AllGather,以减少跨机流量。
3. 正确性条件与常见误区
标称硬件双向峰值 vs. 有效单流总线带宽(Nominal vs. Bus Bandwidth) :
致命误区 :将厂商宣传的物理总双向带宽(例如 H100 NVLink 宣称的 900 GB/s 900\ \text{GB/s} B ring B_{\text{ring}} 正确性要求 :
环形通信中每个节点仅在一个方向单向发送数据,单向理论峰值立即折半为 450 GB/s 450\ \text{GB/s}
GPU SM 注入带宽限制、内存拷贝效率以及 NCCL 协议开销会导致进一步折扣;
NCCL 体系中将测量得到的算法带宽(Algorithm Bandwidth)换算为具有跨算法可比性的总线带宽(Bus Bandwidth) : Bus Bandwidth = Algorithm Bandwidth × 2 ( p − 1 ) p \text{Bus Bandwidth} = \text{Algorithm Bandwidth} \times \frac{2(p - 1)}{p} nccl-tests 在真实机器上实测的稳定 Bus Bandwidth 作为模型输入。
NCCL 内部低延迟协议(LL vs. LL128 vs. Simple)的切换边界 :
NCCL 内部并非使用单一内存传输机制:
LL(Low Latency)协议 :以 8 字节为单位写入,其中 4 字节数据加 4 字节 Flag,接收方轮询 Flag 即可确认数据到达,省去单独的同步,专为小包延迟设计,但有效载荷只有 50%;LL128 协议 :以 128 字节为单位写入,其中 120 字节数据加 8 字节 Flag,有效载荷约 94%,依赖硬件保证 128 字节写入的原子可见性,适合中等报文;Simple 协议 :标准 DMA / GPUDirect RDMA 环形缓冲流水,完全释放物理总线带宽,适用于大张量。若模型忽略了协议切换带来的阶跃变化,将无法解释中等尺寸报文下的性能拐点。
4. 性能与工程取舍
Tree 算法的网络多对一拥塞风险(Incast Congestion) :
Tree 算法在汇聚到树根节点时,存在多个子节点同时向父节点灌包的物理场景。在没有网内计算(In-Network Computing / NVIDIA SHARP)支持的普通以太网或交换机上,极易引发严峻的微突发与 Incast 拥塞,导致报文丢弃与重传时延雪崩;
只有在支持硬件级网内规约(如 InfiniBand SHARP / CollNet)的先进超算网络中,Tree 规约的算力才能达到理想极致。
粗模型筛选 vs. 真实基准实测(Model Filtering vs. Micro-benchmarking) :
α \alpha β \beta 筛选器(Filter) ,能瞬间帮助架构师排除明显错误的拓扑设计与切分策略;但它无法感知由于 NUMA 绑定错误、PCIe Switch 链路争用、热节流掉队者(Straggler)或网络 PFC 死锁带来的动态系统抖动。工程定案前必须在物理集群上运行完整的 all_reduce_perf 压测矩阵并绘制全报文带宽谱图。
具体演示
设集群规模为 64 张 GPU(p = 64 p = 64 α = 5 μ s \alpha = 5\ \mu\text{s} B ring = B tree = 100 GB/s B_{\text{ring}} = B_{\text{tree}} = 100\ \text{GB/s}
小报文规约(S = 1024 Bytes = 1 KB S = 1024\ \text{Bytes} = 1\ \text{KB} :
Ring 算法延迟步数:2 × ( 64 − 1 ) = 126 2 \times (64 - 1) = 126 T ring = 126 × 5 μ s + 2 × 63 64 × 1024 100 × 10 9 ≈ 630 μ s + 0.02 μ s ≈ 630.02 μ s T_{\text{ring}} = 126 \times 5\ \mu\text{s} + 2 \times \frac{63}{64} \times \frac{1024}{100 \times 10^9} \approx 630\ \mu\text{s} + 0.02\ \mu\text{s} \approx 630.02\ \mu\text{s}
Tree 算法层数:⌈ log 2 64 ⌉ = 6 \lceil\log_2 64\rceil = 6 2 × 6 = 12 2 \times 6 = 12 T tree = 12 × 5 μ s + 12 × 1024 100 × 10 9 ≈ 60 μ s + 0.12 μ s ≈ 60.12 μ s T_{\text{tree}} = 12 \times 5\ \mu\text{s} + 12 \times \frac{1024}{100 \times 10^9} \approx 60\ \mu\text{s} + 0.12\ \mu\text{s} \approx 60.12\ \mu\text{s}
结论 :Tree 算法以 10.5 × 10.5\times α \alpha 大报文规约(S = 1 GB = 10 9 Bytes S = 1\ \text{GB} = 10^9\ \text{Bytes} :
Ring 带宽项占主导: T ring ≈ 630 μ s + 2 × 63 64 × 10 9 100 × 10 9 ≈ 0.00063 s + 0.01969 s ≈ 20.32 ms T_{\text{ring}} \approx 630\ \mu\text{s} + 2 \times \frac{63}{64} \times \frac{10^9}{100 \times 10^9} \approx 0.00063\ \text{s} + 0.01969\ \text{s} \approx 20.32\ \text{ms}
Tree 带宽项乘数放大: T tree ≈ 60 μ s + 12 × 10 9 100 × 10 9 ≈ 0.00006 s + 0.12 s ≈ 120.06 ms T_{\text{tree}} \approx 60\ \mu\text{s} + 12 \times \frac{10^9}{100 \times 10^9} \approx 0.00006\ \text{s} + 0.12\ \text{s} \approx 120.06\ \text{ms}
结论 :在朴素非流水线树模型下,Ring 算法反超 Tree 算法 近 6 倍 ,带宽项 β \beta 2 S / B 2S/B nccl-tests 实测为准。
实践任务:唯一代码填空题
补齐 ring/tree 粗略时间,并返回更快算法名。单位统一为秒、字节、字节/秒。
只能修改 TODO/______ 位置,不得删除断言或放宽通过条件。
Code
import mathdef choose_allreduce(world, nbytes, alpha_s, ring_bw, tree_bw):if world < 2 or nbytes < 0 or alpha_s < 0 or ring_bw <= 0 or tree_bw <= 0 :raise ValueError ("invalid model" )= 2 * (world - 1 ) * alpha_s + 2 * (world - 1 ) / world * nbytes / ring_bw= math.ceil(math.log2(world))= 2 * levels * alpha_s + 2 * levels * nbytes / tree_bw# TODO:同时返回选择和两种估算,便于审计。 return ______= choose_allreduce(64 , 1024 , 5e-6 , 100e9 , 100e9 )assert name == "tree" and tree_t < ring_t
检查方法
运行本单元格,所有断言必须通过;再补一个边界输入并解释预期。
Q1
为什么把 NVLink 总双向带宽直接代入 B 会过度乐观?
你的答案:
Q2
小消息 tree 更快的核心原因是什么?
你的答案:
Q3
模型预测 ring 快,实测却慢,排查顺序是什么?
你的答案:
评分规则
代码 4 分:正常输入 2 分、边界输入 1 分、解释 1 分;
Q1~Q3 各 2 分;
一票否决:混淆测量与推测、忽略租户/请求隔离、用平均值掩盖尾延迟、删除失败路径。
参考答案(仅 answer 分支)
先独立完成。核对后请改变一个规模或故障条件重新推演。
Code
import mathdef choose_allreduce(world, nbytes, alpha_s, ring_bw, tree_bw):if world < 2 or nbytes < 0 or alpha_s < 0 or ring_bw <= 0 or tree_bw <= 0 :raise ValueError ("invalid model" )= 2 * (world - 1 ) * alpha_s + 2 * (world - 1 ) / world * nbytes / ring_bw= math.ceil(math.log2(world))= 2 * levels * alpha_s + 2 * levels * nbytes / tree_bwreturn ("ring" if ring <= tree else "tree" ), ring, tree= choose_allreduce(64 , 1024 , 5e-6 , 100e9 , 100e9 )assert name == "tree" and tree_t < ring_t
Q1 参考答案
将硬件厂商宣传的 NVLink 物理双向总峰值带宽直接代入集合通信模型,是脱离物理通信流水线的严重高估:
单向环形拓扑的物理折半(Unidirectional Ring Halving) :厂商宣传的带宽(如 A100 的 600 GB/s 或 H100 的 900 GB/s)是指芯片所有 NVLink 接口在全双工收发时的双向聚合理论极值。而在标准的 Ring AllReduce 算法中,每个 GPU 节点在任一时刻仅向其拓扑环上的单一顺向邻居发送数据。每个节点的有效物理传输通道立即被硬件级折半(例如 900 GB/s 理论极限立即缩水为单向 450 GB/s);
SM 软件协议与内存流水税(Protocol Framing & SM Overhead) :NCCL 通信是由 GPU 上的通信 Kernel 直接驱动的。GPU SM 在执行数据读取、本地规约累加、跨 NVLink 写入缓冲区以及维护流同步标志位时,无法达到 100% 的纯物理线速;此外在小中型报文下采用 LL/LL128 协议时,数据包中必须打包同步 Flag,造成了额外的有效载荷稀释;
跨机异构网络断崖式木桶短板(Inter-Node Network Bottleneck) :在多机分布式训练中,节点内虽然有数百 GB/s 的 NVLink,但跨机通信受制于 PCIe 总线与 InfiniBand/RoCE 网卡带宽(如主流 400 Gbps 网卡单向物理上限仅为 50 GB/s 50\ \text{GB/s} 50 GB/s 50\ \text{GB/s}
科学定额规范 :严禁采用理论宣传值,必须使用 nccl-tests 套件中的 all_reduce_perf 实测出各报文尺寸下的真实总线带宽(Bus Bandwidth) 作为输入。
Q2 参考答案
在小报文场景下,Tree 算法之所以能以数量级优势碾压 Ring 算法,其本质根源在于网络启动延迟项从线性膨胀骤降为对数级收敛(𝒪 ( p ) → 𝒪 ( log 2 p ) \mathcal{O}(p) \to \mathcal{O}(\log_2 p) :
小报文耗时的物理主导项 :当传输数据量 S S S B \frac{S}{B} α \alpha 5 ∼ 15 μ s 5 \sim 15\ \mu\text{s}
步数规模的质变对比 :
对于 p = 64 p = 64 2 ( p − 1 ) = 126 2(p - 1) = 126 126 α 126 \alpha 630 μ s 630\ \mu\text{s}
Tree 算法将节点组织为二叉树或二项式树拓扑,最大树深仅为 ⌈ log 2 p ⌉ = 6 \lceil\log_2 p\rceil = 6 2 × 6 = 12 2 \times 6 = 12 12 α 12 \alpha 60 μ s 60\ \mu\text{s}
步数被压缩了整整 10.5 倍,从而在小数据量下展现出统治性的速度优势;
优势反转的临界物理条件 :在朴素非流水线树模型中,Tree 算法虽然步数少,但每层都要搬运全量数据(带宽项带有 log 2 p \log_2 p 2 S / B 2S/B log 2 p \log_2 p
Q3 参考答案
当成本模型预测 Ring 更快但物理基准压测却显示严重劣于预期时,必须遵循严密的五步全栈排查流:
拓扑与硬件层诊断(Topology & NUMA Affinity) :
运行 nvidia-smi topo -m,确认当前节点内所有 GPU 间的 NVLink 链路是否全绿(排查是否存在某对卡降级为慢速 PCIe);
检查 GPU 与网卡(NIC)、CPU 的 NUMA 亲和性绑定:排查是否存在跨 NUMA Socket 的远端 QPI/UPI 总线穿透,导致跨机数据搬运延迟成倍放大;
NCCL 运行时与自动调优捕获(NCCL Profiling & Subsys Log) :
开启详细环境观测:export NCCL_DEBUG=INFO NCCL_DEBUG_SUBSYS=INIT,COLL,ENV;
检查 NCCL 实际选择的 Algorithm(是否因为拓扑异常被强制退化回 Tree)和 Protocol(是否在大包下误用了吞吐受限的 LL 协议而非 Simple 协议);检查通信通道数(Channels)是否跑满;
跨机网络织网与拥塞检测(Fabric & Rail Health) :
在 InfiniBand / RoCE 交换机侧与网卡侧运行 ibcheckerrors 或 ethtool -S,排查是否存在丢包重传(Packet Retransmission)、PFC 死锁或暂停帧(PFC Pause Frames);
检查多网卡 Rail-Optimized 拓扑中的 ECMP 哈希冲突,排查多张 GPU 的流量是否被错误哈希到了同一条拥塞链路上;
单机掉队者排查(Straggler Detection) :
运行 nvidia-smi -q -d PERFORMANCE,排查集群中是否存在某张 GPU 遭遇硬件过热降频(Thermal Throttling)或供电异常。因为在 Ring 环形拓扑中,整环的流转速度严格受制于环上最慢的一张“掉队卡”;
微基准实测与模型参数反向校准(Micro-benchmarking Calibration) :
剥离上层 PyTorch 代码,直接使用裸 nccl-tests(all_reduce_perf -b 1K -e 1G -f 2)绘制纯净的总线带宽曲线,用真实测量数据修正成本模型中过度乐观的 α \alpha B ring B_{\text{ring}}
参考资料
API 与平台能力会演进;部署前应按目标版本重新核对。