---
title: "第 5 课:ZeRO 与 FSDP(含 FSDP2 架构演进)"
jupyter: python3
---
- 对应官方章节:Zero Redundancy Optimizer (ZeRO) & PyTorch FSDP2 (fully_shard)
- 前置:第 4 课(DP、all-reduce/reduce-scatter/all-gather)
- 状态:未开始
## 本课目标
完成后你需要能够:
- 推导 ZeRO-1/2/3 的每卡静态显存公式并解释每项来源。
- 计算各阶段每步的通信量(2Ψ 与 3Ψ)并说明它们从哪里来。
- 解释为什么激活不能被 ZeRO 分片。
- 说明 FSDP 就是 ZeRO-3 的 PyTorch 实现,以及 prefetch 如何隐藏参数 all-gather。
- 深入拆解 PyTorch FSDP1(FlatParameter 模块包装)到 FSDP2(基于 DTensor 的逐参数分片 `fully_shard`)的范式跃迁。
- 解释为什么 FSDP2 能天然消除 Dynamo 图中断(Graph Break),解锁 `torch.compile` 图级通信计算重叠与 DeviceMesh 2D 并行。
- 对比 ZeRO-3 与流水线并行(第 9 课展开细节)。
## 核心概念
### 1. 显存状态冗余的根源与 ZeRO 的核心洞见
在朴素数据并行(DDP)架构中,为了实现各 Rank 间前向与反向计算的完全解耦,整个集群在 $N_d$ 张显卡上各自保存了一份完整的模型状态镜像。这构成了极大的存储冗余:
- **静态状态全量复制**:每张显卡都必须同时持有 $1\times$ 参数、$1\times$ 梯度以及 $1\times$ 优化器状态(FP32 Master 权重、动量、方差),总计达 $16\Psi$ 字节(以 BF16 + Adam 为例)。
- **每卡显存不随卡数下降**:集群从 8 卡扩到 1024 卡,算力线性增长,每卡静态显存不变。70B 模型每卡静态状态需要 $1120\text{ GB}$,任何现有单卡都放不下。
微软提出的 **ZeRO(Zero Redundancy Optimizer)** 的思路是:各 Rank 共同维护同一个模型,因此可以沿数据并行(DP)维度把这些状态分片,用到时再通过通信重构,从而消除冗余。
如**图 5-1** 与**图 5-2** 所示,ZeRO 将模型状态拆解为三个逐级深入的消除阶段:
```{=html}
<div class="fd fd-seq" role="img"><div class="sd-grid" style="--n:3"><div class="sd-life" style="grid-column:1;grid-row:1/11"></div><div class="sd-life" style="grid-column:2;grid-row:1/11"></div><div class="sd-life" style="grid-column:3;grid-row:1/11"></div><div class="sd-actor" style="grid-column:1;grid-row:1">DP 进程组 (Rank 0..N-1)</div><div class="sd-actor" style="grid-column:2;grid-row:1">本地切片显存 (1/N 参数)</div><div class="sd-actor" style="grid-column:3;grid-row:1">临时全量缓冲区 (全量参数)</div><div class="sd-note sd-note-over" style="grid-column:1/4;grid-row:2;--k:3">前向传播 (Forward Pass: 单层即用即弃)</div><div class="sd-msg sd-r sd-h-arrow" style="grid-column:1/4;grid-row:3;--k:3"><div class="sd-text"><span class="sd-num">1</span>AllGather 广播拼合当前 Layer l 全量参数</div><div class="sd-line"></div></div><div class="sd-msg sd-self" style="grid-column:3/span 1;grid-row:4;--k:1"><div class="sd-text"><span class="sd-num">2</span>本地输入微批次执行前向矩阵乘与激活</div><div class="sd-loop"></div></div><div class="sd-msg sd-self sd-dash" style="grid-column:3/span 1;grid-row:5;--k:1"><div class="sd-text"><span class="sd-num">3</span>计算完毕,立即释放临时全量参数 (显存回落)</div><div class="sd-loop"></div></div><div class="sd-note sd-note-over" style="grid-column:1/4;grid-row:6;--k:3">反向传播 (Backward Pass: 逆向二次拉取)</div><div class="sd-msg sd-r sd-h-arrow" style="grid-column:1/4;grid-row:7;--k:3"><div class="sd-text"><span class="sd-num">4</span>二次 AllGather 拼合 Layer l 全量参数</div><div class="sd-line"></div></div><div class="sd-msg sd-self" style="grid-column:3/span 1;grid-row:8;--k:1"><div class="sd-text"><span class="sd-num">5</span>结合前向激活计算输入激活梯度与局部参数梯度</div><div class="sd-loop"></div></div><div class="sd-msg sd-self sd-dash" style="grid-column:3/span 1;grid-row:9;--k:1"><div class="sd-text"><span class="sd-num">6</span>参数使用完毕立即释放</div><div class="sd-loop"></div></div><div class="sd-msg sd-l sd-h-arrow" style="grid-column:2/4;grid-row:10;--k:2"><div class="sd-text"><span class="sd-num">7</span>ReduceScatter 将梯度归约分片写回本地切片槽位</div><div class="sd-line"></div></div></div></div>
```
<p class="caption" align="center"><em>图 5-1:ZeRO-3 (FSDP) 每训练步动态拉取与即时释放通信流转拓扑</em></p>
### 2. ZeRO 阶段 1、2、3 的显存拆解与数学推导
设全模型参数量为 $\Psi$,数据并行规模为 $N_d$。在经典的 BF16/FP16 混合精度与 AdamW 优化器配置下(状态乘数 $k=12$:4 字节 FP32 Master 权重 + 4 字节一阶动量 $m$ + 4 字节二阶方差 $v$):
1. **ZeRO-0(朴素 DDP)**:无任何状态分片,每张卡承担全量开销:
$$M_0 = \underbrace{2\Psi}_{\text{BF16 参数}} + \underbrace{2\Psi}_{\text{BF16 梯度}} + \underbrace{12\Psi}_{\text{FP32 优化器状态}} = 16\Psi \text{ 字节/卡}$$
2. **ZeRO-1(优化器状态分片,$\text{P}_{\text{os}}$)**:
- 优化器的动量和方差以及 FP32 Master 权重按 $1/N_d$ 均分到各 Rank。
- 每张卡依然保留全量 BF16 参数与全量 BF16 梯度:
$$M_1 = 2\Psi + 2\Psi + \frac{12\Psi}{N_d} = 4\Psi + \frac{12\Psi}{N_d}$$
- 当 $N_d = 64$ 时,优化器状态显存从 $12\Psi$ 骤降至 $0.1875\Psi$,显存从 $16\Psi$ 降至约 $4.19\Psi$(节省约 74% 显存)。
3. **ZeRO-2(优化器状态 + 梯度分片,$\text{P}_{\text{os+g}}$)**:
- 在 ZeRO-1 的基础上,进一步将梯度切片。
- 反向传播计算过程中,各层梯度通过 **Reduce-Scatter** 同步后,每个 Rank 仅保留属于自己负责的 $1/N_d$ 梯度切片,其余 $N_d-1$ 份梯度被立刻释放:
$$M_2 = 2\Psi + \frac{2\Psi + 12\Psi}{N_d} = 2\Psi + \frac{14\Psi}{N_d}$$
- 当 $N_d = 64$ 时,显存进一步压缩至约 $2.22\Psi$。
4. **ZeRO-3(优化器状态 + 梯度 + 参数全分片,$\text{P}_{\text{os+g+p}}$,即 PyTorch FSDP)**:
- 连前向与反向所需的模型参数本身也分片。
- 每张卡常驻显存中仅持有 $1/N_d$ 的参数切片。仅在计算某一层的前向或反向时,通过 **All-Gather** 临时动态拼出全量参数,计算完毕后**立即销毁释放**:
$$M_3 = \frac{2\Psi + 2\Psi + 12\Psi}{N_d} = \frac{16\Psi}{N_d}$$
- 当 $N_d \to \infty$ 时,静态模型显存理论上趋近于 0(实际受限于单层参数峰值)。
*注:若开启 FP32 梯度累积,ZeRO-1 因梯度全量驻留需额外增加 $4\Psi$;而 ZeRO-2/3 因梯度分片仅需额外增加 $\frac{4\Psi}{N_d}$。*
:::: {.vfig}
::: {.vfig-title}
ZeRO 各阶段的单卡显存与通信量($N_d$ 为 DP 卡数)
:::
::::: {.vfig-grid style="--cols:4"}
::: {.vfig-card .c-slate}
**DDP**
$16\Psi$
通信:AllReduce $2\Psi$
:::
::: {.vfig-card .c-blue}
**ZeRO-1:分片优化器**
$4\Psi + 12\Psi/N_d$
通信 $2\Psi$;$N_d=64$ 时省约 74%
:::
::: {.vfig-card .c-green}
**ZeRO-2:再分片梯度**
$2\Psi + 14\Psi/N_d$
通信 $2\Psi$;$N_d=64$ 时省约 86%
:::
::: {.vfig-card .c-purple}
**ZeRO-3 / FSDP:再分片参数**
$16\Psi/N_d$
通信 $3\Psi$(前向、反向各 All-Gather 一次)
:::
:::::
::::
<p class="caption">图 5-2:ZeRO 逐级分片的显存与通信量</p>
::: {.img-card}
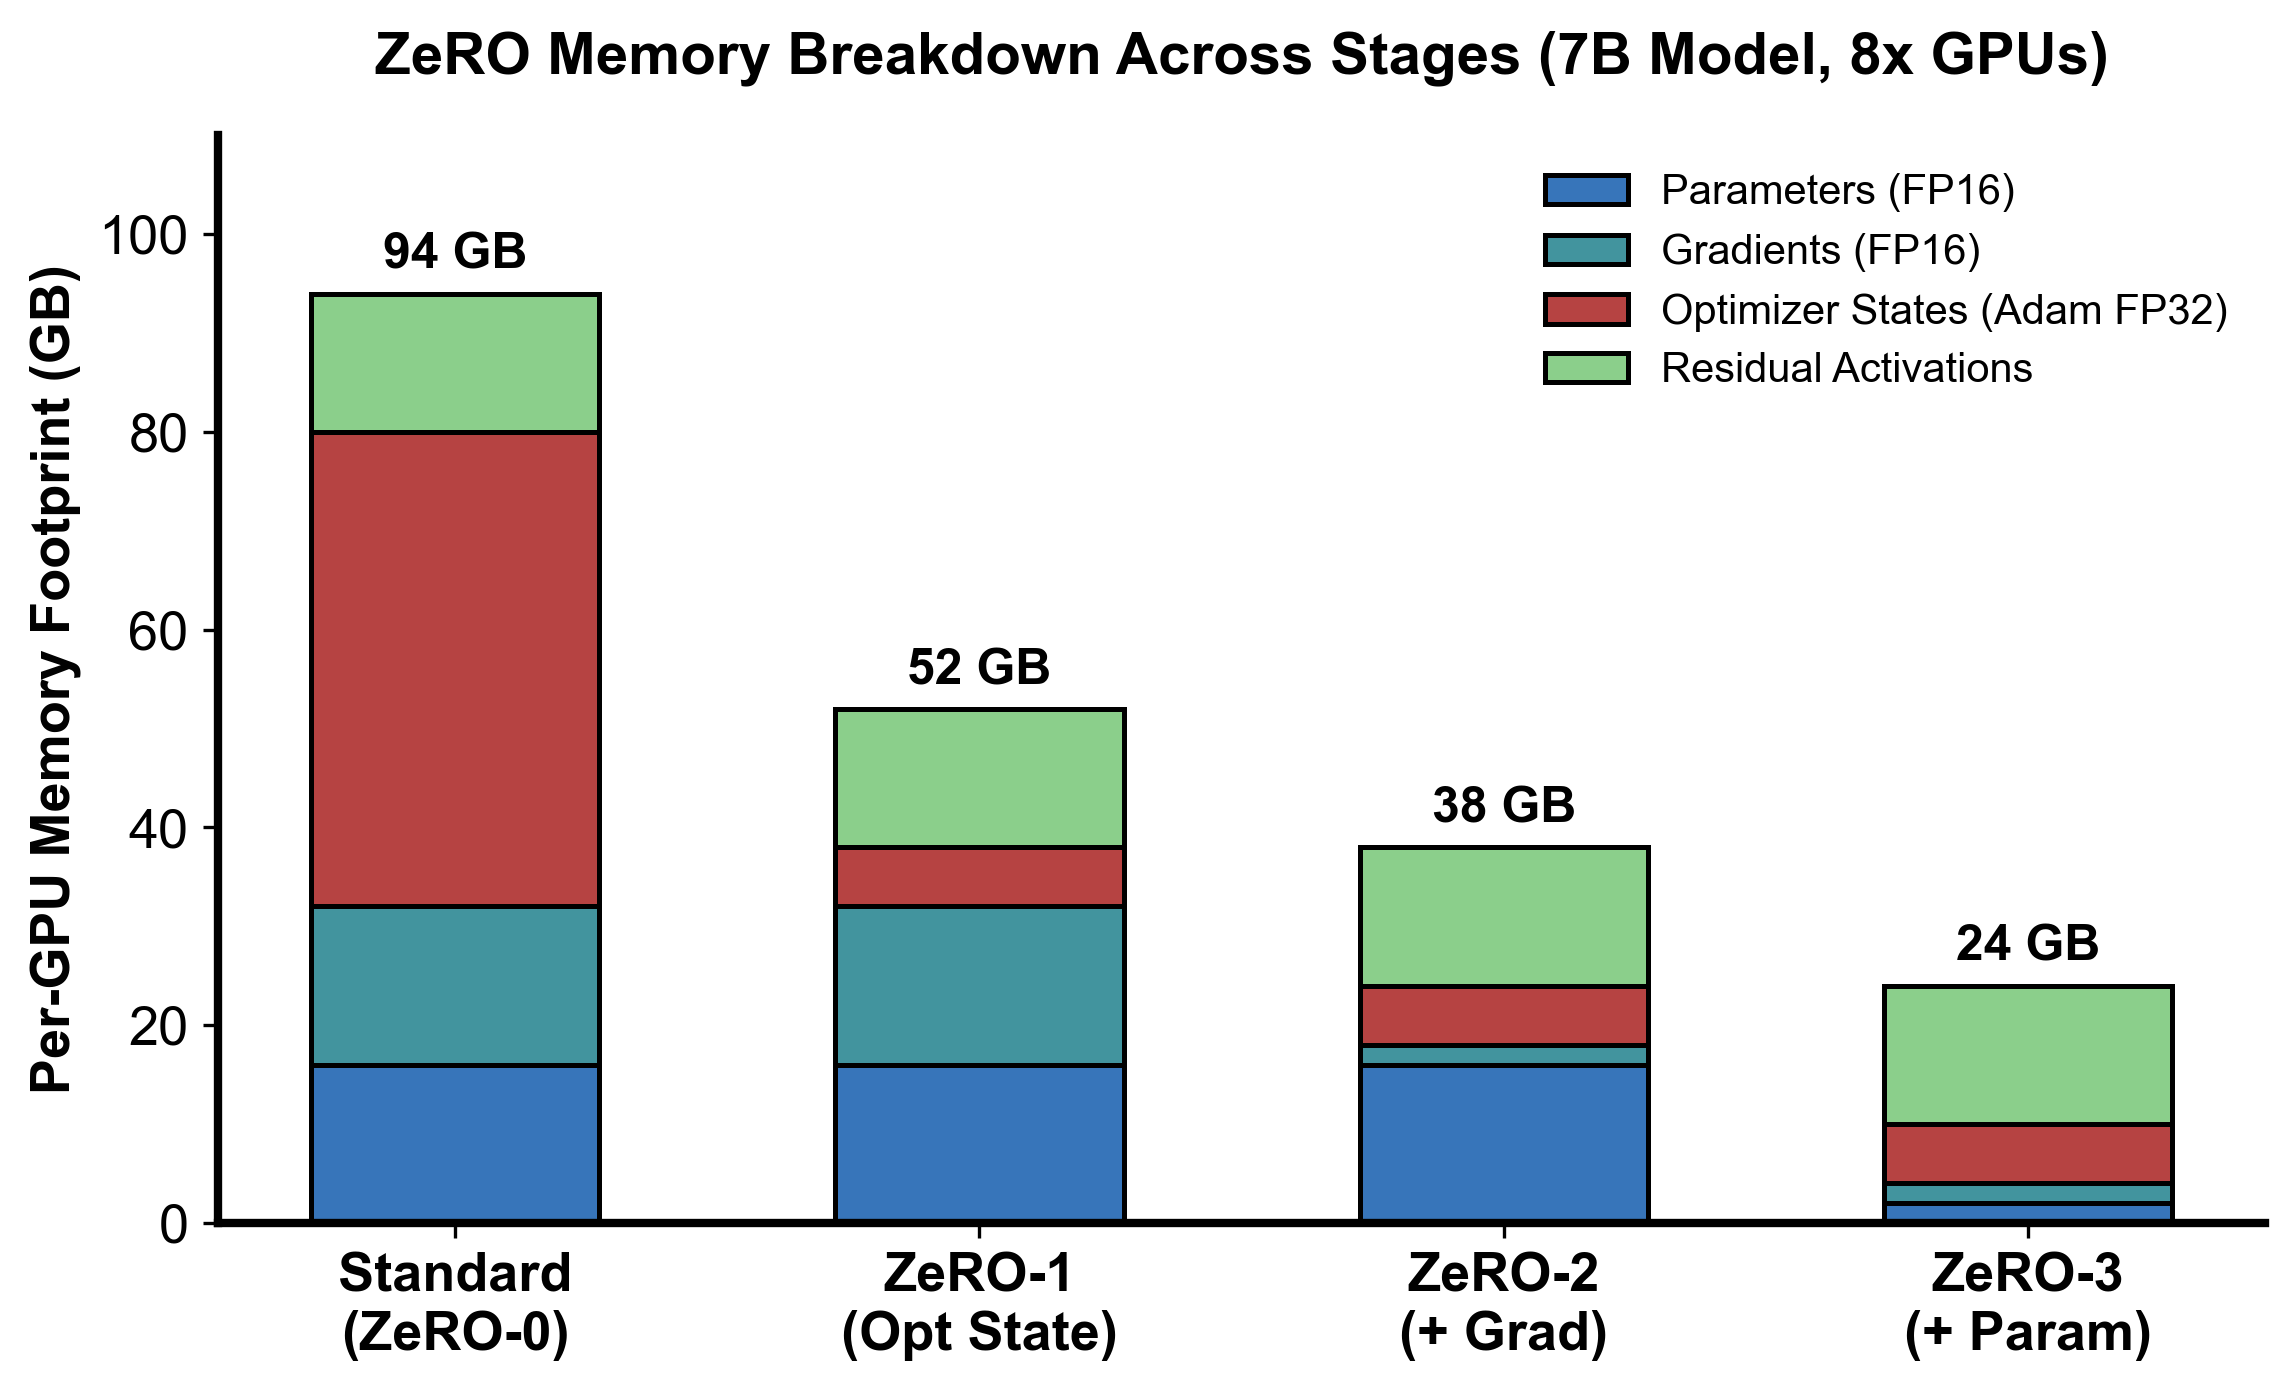{width="85%"}
<p class="caption">图 5-3:ZeRO 各阶段单卡显存占用对比(7B 模型 8 卡环境)</p>
:::
### 3. 通信账本严密推导:为什么 ZeRO-1/2 是 $2\Psi$,而 ZeRO-3 是 $3\Psi$
分片并不必然增加通信量,按集合通信逐项计算如下:
#### ZeRO-1 与 ZeRO-2 的通信等价性(总通信量 = $2\Psi$)
- 朴素 DDP:每个 step 反向传播结束后,发射一次全局 **AllReduce** 同步全量梯度。通信量为:
$$V_{\text{DDP}} = 2 \times \frac{N_d - 1}{N_d} \Psi \approx 2\Psi$$
- ZeRO-1/2:
1. 反向传播产出各层梯度后,系统不再发射 AllReduce,而是发射 **Reduce-Scatter**。每个 Rank 只接收并聚合自己所负责的 $1/N_d$ 梯度切片。其通信量恰好为 AllReduce 的一半:
$$V_{\text{RS}} = \frac{N_d - 1}{N_d} \Psi \approx \Psi$$
2. 各卡使用自己的 $1/N_d$ 梯度切片,在本地独立更新各自持有的 $1/N_d$ FP32 优化器状态与 Master 权重,并将其就地转换为 BF16 格式。此时每张卡拥有更新后的 $1/N_d$ 模型参数。
3. 系统发射一次 **All-Gather** 算子,在所有卡之间互通有无,将各自的 $1/N_d$ 新参数拼回全量模型参数副本。其通信量同样为:
$$V_{\text{AG}} = \frac{N_d - 1}{N_d} \Psi \approx \Psi$$
- **总通信量计算**:
$$V_{\text{ZeRO-1/2}} = V_{\text{RS}} + V_{\text{AG}} = \Psi + \Psi = 2\Psi$$
- **关键结论**:ZeRO-1 与 ZeRO-2 每个优化步的总通信量与朴素 DDP 相同。ZeRO-2 比 ZeRO-1 多省约 $2\Psi(1 - 1/N_d)$ 的梯度显存,在不做梯度累积时没有额外通信。但开启梯度累积后两者不同:ZeRO-1 可以在本地累加全量梯度、只在最后一个 micro-batch 做一次 Reduce-Scatter;ZeRO-2 不保留全量梯度,每个 micro-batch 都要 Reduce-Scatter 一次,通信次数变为 $\text{grad\_accum}$ 倍。因此 ZeRO-2 并非总是优于 ZeRO-1,需要按累积步数与带宽权衡。
#### ZeRO-3(FSDP)的通信代价(总通信量 = $3\Psi$)
ZeRO-3 为了将参数显存从 $2\Psi$ 砍到 $2\Psi / N_d$,付出了额外的通信代价:
1. **前向传播(All-Gather 参数)**:由于每卡仅存 $1/N_d$ 参数,在计算第 $l$ 层前向之前,必须先对该层权重执行一次 All-Gather,瞬时拼出完整的参数张量。整网前向累计通信量为:
$$V_{\text{Fwd\_AG}} = \frac{N_d - 1}{N_d} \Psi \approx \Psi$$
该层前向计算完毕后,非本地参数被立即释放,显存回落。
2. **反向传播(再次 All-Gather 参数)**:反向传播链式求导必须再次用到前向时的权重张量 $W_l$。因此在反向逐层推进时,必须再次对第 $l$ 层执行 All-Gather。整网反向参数通信量为:
$$V_{\text{Bwd\_AG}} = \frac{N_d - 1}{N_d} \Psi \approx \Psi$$
计算完该层的输入导数与权重导数后,非本地参数再次被立即丢弃。
3. **反向传播(Reduce-Scatter 梯度)**:计算出的梯度立即执行 Reduce-Scatter,各卡只留属于自己的 $1/N_d$ 梯度切片。通信量为:
$$V_{\text{Bwd\_RS}} = \frac{N_d - 1}{N_d} \Psi \approx \Psi$$
4. **优化器更新(零通信)**:各卡直接在本地更新属于自己的 $1/N_d$ 状态,没有任何网络通信。
- **总通信量计算**:
$$V_{\text{ZeRO-3}} = V_{\text{Fwd\_AG}} + V_{\text{Bwd\_AG}} + V_{\text{Bwd\_RS}} = \Psi + \Psi + \Psi = 3\Psi$$
- ZeRO-3 的通信量相比 DDP / ZeRO-2 增加了 **50%(从 $2\Psi$ 升至 $3\Psi$)**。
### 4. 异步流水预取(Prefetching)与重叠原理
如**图 5-4** 的执行全景所示,PyTorch FSDP(ZeRO-3)在实际运行时依靠专用的 CUDA Stream 建立流水线,尽可能隐藏这额外的通信:
:::: {.vfig}
::: {.vfig-title}
ZeRO-3 一个训练步的通信(单步共约 $3\Psi$)
:::
::::: {.vfig-grid .vfig-flow style="--cols:3"}
::: {.vfig-card .c-blue}
**前向($\Psi$)**
- 逐层 All-Gather 当前层完整参数
- 算完该层立即释放完整参数
- 每卡只常驻 $1/N_d$ 参数
:::
::: {.vfig-card .c-orange}
**反向($2\Psi$)**
- 再次 All-Gather 当前层参数(前向已释放)
- 求梯度后 Reduce-Scatter
- 每卡只留 $1/N_d$ 梯度
:::
::: {.vfig-card .c-green}
**优化器(0 通信)**
- 每卡只更新自己的 $1/N_d$
- Adam 状态 $12\Psi/N_d$
- 写回 BF16 参数分片
:::
:::::
::: {.vfig-key}
Prefetch:在计算第 $l$ 层时预取第 $l+1$ 层参数,把 All-Gather 藏在计算后面;每卡计算量很小(DP 很大、micro-batch 很小)时通信可能盖不住
:::
::::
<p class="caption">图 5-4:ZeRO-3 前向、反向、优化器三个阶段的通信与显存</p>
- **前向预取(Forward Prefetch)**:当 GPU 计算流在第 $l$ 层执行 GEMM 矩阵乘时,通信流已经提前在后台对第 $l+1$ 层参数发射异步 `All-Gather`。
- **反向预取(Backward Prefetch)**:当 GPU 计算流在计算第 $l$ 层的反向导数时,通信流一方面异步对第 $l$ 层的梯度发射 `Reduce-Scatter`,另一方面并行对上一层(Layer $l-1$)的参数发射 `All-Gather` 预取。
- **重叠成功的先决条件**:单层的计算时间必须大于通信时间($T_{\text{compute}} \ge T_{\text{comm}}$)。如果网络总线较慢(如跨节点 PCIe 或以太网),或者 $N_d$ 过大导致 Ring Latency 累积,计算流将被迫空转等待参数到齐,训练吞吐大幅滑坡。
### 5. 为什么激活显存(Activation)无法被 ZeRO 分片?
这是一个极为经典的面试陷阱:**ZeRO-3 能否解决长文本(如 32k/128k 上下文)带来的显存爆炸?**
不能。
- **状态的语义差异**:ZeRO 的本质是消除数据并行副本间的“重复信息(Redundancy)”。模型参数、优化器状态在各 DP Rank 之间原本是完全相同的,所以切片后可以通过集合通信按需重构。
- **激活的独占性**:每个 DP 节点处理的是互不重叠的 Micro-Batch 数据。Rank 0 上的输入样本与 Rank 1 上的输入样本完全不同,因此产生的中间层激活值 $X_l$ 也**各不相同**。它们之间**没有任何冗余**可供消除。
- **长序列的内存归宿**:在长文本或大 Batch 场景下,激活显存随序列长度 $s$ 呈二次方增长($O(s^2)$)。在 ZeRO-3 消除模型静态状态后,显存瓶颈将**完全转移至激活显存**。必须结合第 2 课的选择性激活重计算、第 6 课的张量并行(TP)以及第 8 课的序列/上下文并行(CP),才能解开激活显存的束缚。
### 6. 工程选型准则:FSDP 与扩展边界
1. **单层参数上限约束**:ZeRO-3(FSDP)在执行某一层的计算时,必须临时容纳该层的全量参数与全量激活。如果单层的参数量本身就超过了单卡显存(例如某些超大 MoE 层的专家权重),ZeRO-3 将无能为力,必须借助张量并行(TP)在机内切分单层矩阵。
2. **512 卡扩展性红线**:在大规模集群中,当 $N_d > 512$ 时,跨节点频繁发射小层的 All-Gather 与 Reduce-Scatter 会使通信延迟项 $2(N_d-1)\alpha$ 剧烈放大,Prefetch 无法完全掩盖通信开销。业内主流做法是采用 **FSDP / ZeRO-3 与 TP / PP 构成的 3D 混合并行**。
### 7. 工业级演进:从 FSDP1 到 FSDP2 的范式革命
在 PyTorch 分布式生态中,**ZeRO-3 是顶层数学抽象与显存/通信账本,而 FSDP 则是其在工业界最核心的工程落地**。
然而,在 PyTorch 2.x 时代之前诞生的 **FSDP1(`torch.distributed.fsdp.FullyShardedDataParallel`)** 随着大模型训练走向数千卡集群与 `torch.compile` 全图编译,暴露出了一系列难以调和的结构性硬伤。PyTorch 团队随后在 2.4+ 重构推出了新一代 **FSDP2(`torch.distributed.fsdp.fully_shard`)**。这一重构不是单纯的 API 语法糖,而是分布式系统执行机制、编译期调度与显存所有权的深刻变革。
#### 7.1 FSDP1 的底层机制与三大致命缺陷
FSDP1 采用的是经典的 **模块级包装器(Module Wrapper Pattern)** 与 **一维扁平参数(FlatParameter)** 机制:
1. **扁平拼接与存储篡改(FlatParameter Mutation)**:
- FSDP1 强制用户指定 `auto_wrap_policy`,将子模块逐层包装为 `FullyShardedDataParallel` 实例。
- 在每个包装单元内,FSDP1 遍历所有属于该模块的子参数,将它们拍平成一个一维大 Tensor(`FlatParameter`),并在该一维 Tensor 上沿 DP 维度切分。
- **工程痛点**:在前向传播前(`pre_forward_hook`),FSDP1 发起 All-Gather 收集完整的 FlatParameter,然后通过连续的切片视图(Tensor Views)动态重塑并赋给各个子模块的 `param.data`;计算完毕后(`post_forward_hook`),再强制销毁全量视图释放显存。这种在 Python 运行时不断劫持、解构、原地变异对象属性的操作,导致参数所有权极其混乱。
2. **与 `torch.compile`(TorchDynamo / AOTAutograd)的结构性冲突**:
- `torch.compile` 的核心在于通过 TorchDynamo 静态捕获 Python 字节码计算图,并由 AOTAutograd 与 Inductor 生成融合 GPU 内核。
- FSDP1 深度依赖 Python 层面的动态 Hook 修改模块内部属性,Dynamo 无法看穿这种复杂且带有副作用的元编程变异,直接引发大量的 **图中断(Graph Break)**。
- 图一旦被截断,Inductor 就只能退化为生成多个孤立的小计算子图。非但无法发挥跨算子访存融合(Fusion)的优势,更导致 CUDA Stream 之间的异步通信调度完全失控,前向与反向 Prefetch 重叠效率急剧恶化。
3. **2D/3D 混合并行组合困难与显存垫片浪费**:
- 当需要将 TP(张量并行)与 FSDP 叠加时,由于 FSDP1 将所有参数强行打包为一维 FlatParameter,它无法理解多维网格(DeviceMesh)的语义,导致两者结合必须编写大量脆弱的胶水转换代码。
- 此外,如果某层参数量不能被 World Size 整除,FlatParameter 必须在末尾补齐 Padding 显存垫片,在小参数、不规则参数较多的网络结构中造成显著的内存碎片与峰值暴涨。
#### 7.2 FSDP2 的核心范式突破:基于 DTensor 的逐参数分片
FSDP2 彻底废弃了 Module Wrapper 和 FlatParameter,确立了 **Composable API(组合式 API)** 与 **逐参数分片(Per-Parameter Sharding via DTensor)** 的全新架构(如**图 5-5** 所示):
:::: {.vfig}
::: {.vfig-title}
FSDP1 与 FSDP2 架构范式对比:FlatParameter 包装 vs DTensor 逐参数分片
:::
::::: {.vfig-grid style="--cols:2"}
::: {.vfig-card .c-orange}
**FSDP1:FlatParameter 侵入式包装**
1. **结构破坏**:将子模块所有参数拍平拼成一维大张量 `FlatParameter`,改变原生 Module 类树
2. **粗粒度通信**:以整块 FlatParameter 为单元发起 All-Gather / Reduce-Scatter
3. **动态切片**:Python Hook 动态 slice 视图并原地覆写 `param.data`
4. **编译瓶颈**:运行时属性变异引发大量 **Graph Break**,全图被打碎,无法跨层融合算子,破坏 Stream 通信重叠
:::
::: {.vfig-card .c-blue}
**FSDP2:DTensor 逐参数非侵入式分片**
1. **结构原生**:保持原生 `nn.Module` 树不变,`fully_shard(module)` 函数式组合接入
2. **逐参数分片**:每个参数独立保留原生高维形状,物理存储包装为 `DTensor`(挂载 DP 维 `Shard(0)`)
3. **图内调度**:通信算子(All-Gather / Reduce-Scatter)作为显式 IR 节点内嵌在 AOTAutograd 计算图中
4. **全图编译**:**零 Graph Break**;Inductor 编译器在拓扑排序阶段全局规划通信节点,实现硬件级确定的通信与计算重叠
:::
:::::
::: {.vfig-key}
核心差异:FSDP1 是在 Python 动态层用 Hook 做“运行时修补”;FSDP2 是把分布式切分下沉到 DTensor 算子层与编译图 IR,天然与 `torch.compile` 全图融合及异步重叠协同。
:::
::::
<p class="caption">图 5-5:FSDP1(FlatParameter 侵入式包装)与 FSDP2(DTensor 逐参数非侵入式分片)架构范式对比</p>
1. **逐参数原生保留(Per-Parameter Sharding)**:
- 每一个参数(如 `Linear.weight` 形状 `[H, D]`)不再与邻近参数混合拼凑,而是各自独立保留原生的高维形状。
- 物理存储上,该参数被声明为 **DTensor(Distributed Tensor)**,并挂载分布策略 `Shard(0)`。单卡物理显存只分配本地切片 `[H / N_d, D]`,零额外显存垫片。
2. **非侵入式 Composable API(`fully_shard`)**:
- 抛弃 `model = FSDP(model)` 这种侵入类继承树的模式,改为函数式增强:
```python
from torch.distributed.fsdp import fully_shard

# 仅作用于模块,不改变 module 的类型、层次结构和命名空间
for layer in model.layers:
    fully_shard(layer, mesh=dp_mesh)
fully_shard(model, mesh=dp_mesh)
```
- 模型在 Python 视角依然是一个纯正的 `nn.Module`,`state_dict` 存取、参数冻结(`requires_grad=False`)、权重绑定(Weight Tying)以及 PEFT/LoRA 插件可以完全按照单机习惯编写。
3. **原生解锁 `torch.compile`(零 Graph Break + 图内通信计算重叠)**:
- DTensor 是 PyTorch 2.x C++ 内核与 Dispatcher 的一等公民(First-Class Citizen),Dynamo 能够像处理常规 Tensor 一样一气呵成追踪整网,实现 **零 Graph Break**。
- 集合通信算子(All-Gather、Reduce-Scatter)不再是黑盒隐式的 Python Hook,而是作为显式 IR 节点内嵌在 AOTAutograd 导出的计算图内。
- 编译器后端 Inductor 在拓扑排序和显存规划时,能自主感知这些通信节点,静态地将通信任务向前调度(Schedule Ahead),与计算密集的 GEMM 内核实现硬件级别的双流并发重叠(Communication-Computation Overlap)。
#### 7.3 多维拓扑:基于 DeviceMesh 的 2D 正交并行(FSDP2 + TP)
在超千亿参数模型训练中,业内标准实践是“机内 8 卡走 TP,跨机走 FSDP”。FSDP2 借助 `DeviceMesh` 让这种多维并行变得极其优美且数学正交(如**图 5-6** 所示):
:::: {.vfig}
::: {.vfig-title}
2D DeviceMesh (dp=2, tp=4) 上的正交张量切分流水线
:::
::::: {.vfig-grid .vfig-flow style="--cols:3"}
::: {.vfig-card .c-slate}
**1. 全局模型参数**
$W \in \mathbb{R}^{4096 \times 4096}$
未切分的逻辑视图,对应单层全量线性权重
:::
::: {.vfig-card .c-orange}
**2. TP 维按列切分**
`Shard(1)` 沿 `"tp"` 维
切分后为 $[4096, 1024]$,由机内 4 卡组成的 TP 组分别持有
:::
::: {.vfig-card .c-green}
**3. FSDP2 维按行切分**
`Shard(0)` 沿 `"dp"` 维
各卡本地最终存储 $[2048, 1024]$ DTensor,Placements: `[Shard(0), Shard(1)]`
:::
:::::
::::: {.vfig-grid style="--cols:2; margin-top: 14px;"}
::: {.vfig-card .c-blue}
**DP Rank 0(节点 0 / 卡 0~3)**
- **GPU 0**: 本地分片 $[2048, 1024]$(TP 0)
- **GPU 1**: 本地分片 $[2048, 1024]$(TP 1)
- **GPU 2**: 本地分片 $[2048, 1024]$(TP 2)
- **GPU 3**: 本地分片 $[2048, 1024]$(TP 3)
:::
::: {.vfig-card .c-purple}
**DP Rank 1(节点 1 / 卡 4~7)**
- **GPU 4**: 本地分片 $[2048, 1024]$(TP 0)
- **GPU 5**: 本地分片 $[2048, 1024]$(TP 1)
- **GPU 6**: 本地分片 $[2048, 1024]$(TP 2)
- **GPU 7**: 本地分片 $[2048, 1024]$(TP 3)
:::
:::::
::: {.vfig-key}
运行时执行路径:前向时首先在 DP 维 All-Gather 重构 $[4096, 1024]$ 本地 TP 张量,片上 GEMM 完成后在 TP 维 All-Reduce 或 Reduce-Scatter,双层通信完全正交解耦。
:::
::::
<p class="caption">图 5-6:2D DeviceMesh 拓扑下 FSDP2 (DP) 与 Tensor Parallelism (TP) 的双重正交张量切分</p>
- **双重 Placement 描述**:参数的逻辑切分状态被精准描述为 `Placements = [Shard(0), Shard(1)]`。
- **运行时解耦协同**:前向传播时,DTensor 运行时首先在 `dp` Mesh 上针对 `Shard(0)` 发起 All-Gather 重构 `[4096, 1024]`,随后在 GPU 片上完成矩阵乘,最后在 `tp` Mesh 上发起 All-Reduce 或 Reduce-Scatter。整个过程完全无需任何定制化胶水层。
#### 7.4 FSDP1 vs FSDP2 核心架构决策对比表
| 架构特性维度 | FSDP1 (`FullyShardedDataParallel`) | FSDP2 (`fully_shard`) | 架构升级带来的工程收益 |
| :--- | :--- | :--- | :--- |
| **底层参数抽象** | 一维 `FlatParameter`(将模块内所有子参数强行压平拼接) | 原生多维 `DTensor`(逐参数保留高维 Shape) | 彻底消除不必要的扁平化与动态视图重塑 |
| **API 设计模式** | Module Wrapper(包装并生成新的代理类) | Composable API(函数式原地施加分片规则) | 不变异 Module 树结构,对 LoRA / 冻结完全透明 |
| **`torch.compile` 兼容性** | 极差(动态 Hook 频繁修改属性,引发大量 Graph Break) | **原生完美支持**(零 Graph Break,全图追踪) | 释放 Inductor 跨算子融合与图级调度全部潜能 |
| **通信算子表现形式** | Python Runtime Hook 隐式发射到 CUDA Stream | 计算图内显式的 First-Class IR 节点 | 编译器可在图级别全局静态调度通信与计算重叠 |
| **多维并行结合 (如 +TP)** | 极其复杂,需特化封装和脆弱的胶水适配 | 基于 `DeviceMesh` 声明多维 Placements 原生支持 | 2D/3D 并行组合正交清晰,维护成本降为零 |
| **显存碎片与垫片开销** | 存在整块 FlatParameter 导致的 Padding 与内存碎片 | 逐参数精细化内存分配,按需即时释放 | 显存水位更加平稳,峰值开销可预测性更强 |
| **工业界现状与趋势** | 属于 Legacy 遗留方案,维护成本高 | **PyTorch 2.4+ 官方唯一力推的新一代标准** | 推荐在所有新启动的大规模分布式训练项目中全面采用 |
#### 7.5 FSDP2 最小工业级生产范式代码演示
以下展示在现代 PyTorch 中结合 2D DeviceMesh、混合精度与 `torch.compile` 的推荐标准配置模板:
```python
import torch
import torch.nn as nn
from torch.distributed.device_mesh import init_device_mesh
from torch.distributed.fsdp import fully_shard, MixedPrecisionPolicy

def setup_fsdp2_training(model: nn.Module, dp_size: int, tp_size: int):
    # 1. 初始化 2D 设备网格:明确划分 DP 与 TP 通信域
    mesh_2d = init_device_mesh(
        "cuda",
        mesh_shape=(dp_size, tp_size),
        mesh_dim_names=("dp", "tp")
    )
    dp_mesh = mesh_2d["dp"]

    # 2. 配置混合精度策略:参数在通信与计算时转为 BF16,优化器与 Master Weights 保持 FP32
    mp_policy = MixedPrecisionPolicy(
        param_dtype=torch.bfloat16,
        reduce_dtype=torch.float32,     # 梯度在 Reduce-Scatter 时采用 FP32 规约保证精度
    )

    # 3. 逐层施加 FSDP2 分片(对 TransformerBlock 分片,实现逐层 All-Gather / 释放流水)
    for block in model.transformer_blocks:
        fully_shard(block, mesh=dp_mesh, mp_policy=mp_policy)

    # 4. 对最外层根模型应用 fully_shard(管理 Embedding 和 Output Head)
    fully_shard(model, mesh=dp_mesh, mp_policy=mp_policy)

    # 5. 原生接入 torch.compile:全图捕获并实现图级通信计算并发调度
    compiled_model = torch.compile(model)
    return compiled_model
```
## 具体演示与数值推演
以一个 7B 模型($\Psi = 7 \times 10^9$ 参数)为例,在 BF16 混合精度与 AdamW 优化器($k=12$)配置下,无 FP32 梯度累积时,各阶段单卡静态显存(以 GB 计,换算系数 $10^9$)对比:
| 数据并行度 $N_d$ | ZeRO-0 (朴素 DP) | ZeRO-1 (分片优化器) | ZeRO-2 (分片优化器+梯度) | ZeRO-3 (全分片 FSDP) | 单步通信量 |
|:---:|:---:|:---:|:---:|:---:|:---:|
| **$N_d = 1$ (单卡基准)** | $112.0\text{ GB}$ | $112.0\text{ GB}$ | $112.0\text{ GB}$ | $112.0\text{ GB}$ | $0\text{ (无通信)}$ |
| **$N_d = 8$ (单机 8 卡)** | $112.0\text{ GB}$ | $38.5\text{ GB}$ | $26.3\text{ GB}$ | $14.0\text{ GB}$ | $2\Psi \text{ (Z1/2)} \ / \ 3\Psi \text{ (Z3)}$ |
| **$N_d = 64$ (8 节点集群)** | $112.0\text{ GB}$ | $29.3\text{ GB}$ | $15.5\text{ GB}$ | $1.75\text{ GB}$ | $2\Psi \text{ (Z1/2)} \ / \ 3\Psi \text{ (Z3)}$ |
- **公式验算**:
- $N_d = 8$ 时:
- ZeRO-1: $2\times 7 + 2\times 7 + \frac{12\times 7}{8} = 14 + 14 + 10.5 = 38.5\text{ GB}$
- ZeRO-2: $2\times 7 + \frac{(2+12)\times 7}{8} = 14 + 12.25 = 26.25 \approx 26.3\text{ GB}$
- ZeRO-3: $\frac{16\times 7}{8} = 14.0\text{ GB}$
- $N_d = 64$ 时:
- ZeRO-3 静态显存仅需 $\frac{16\times 7}{64} = 1.75\text{ GB}$(7B 模型)。同样 $N_d = 64$ 下,70B 模型为 $\frac{16\times 70}{64} = 17.5\text{ GB}$/卡,且尚未计入激活、通信缓冲区与运行时开销。
- 通信量对比:$2\Psi = 14\text{G 数值}$(BF16 下为 $28\text{ GB}$ 通信),$3\Psi = 21\text{G 数值}$(BF16 下为 $42\text{ GB}$ 通信)。
## 代码填空题
补全以下程序:各阶段每卡静态显存与通信量计算,并生成上表。
```{python}
#| course_role: exercise
def zero_memory_per_gpu(
    num_params: int,
    dp: int,
    stage: int,                     # 0=朴素DP, 1, 2, 3
    k: int = 12,                    # Adam 混合精度优化器状态乘数(4 master + 4 m + 4 v)
    fp32_grad_accum: bool = False,
) -> float:
    """
    返回每个 GPU 的静态显存(bytes)。

    公式(BF16 参数/梯度 + FP32 master weights + FP32 Adam 状态):
        ZeRO-0: 2Ψ + 2Ψ + kΨ
        ZeRO-1: 2Ψ + 2Ψ + kΨ/dp
        ZeRO-2: 2Ψ + (2Ψ + kΨ)/dp
        ZeRO-3: (2Ψ + 2Ψ + kΨ)/dp
    可选 FP32 梯度累积:
        ZeRO-1 的梯度不分片,额外加 4Ψ;
        ZeRO-2/3 梯度分片,额外加 4Ψ/dp。
    """
    if num_params <= 0 or dp <= 0:
        raise ValueError("num_params and dp must be positive")
    if stage not in (0, 1, 2, 3):
        raise ValueError("stage must be 0..3")

    params_bf16 = 2 * num_params
    grads_bf16 = 2 * num_params
    opt_fp32 = k * num_params

    extra = 0.0
    if fp32_grad_accum:
        extra = 4 * num_params if stage <= 1 else 4 * num_params / dp

    if stage == 0:
        per_gpu = params_bf16 + grads_bf16 + opt_fp32 + extra
    elif stage == 1:
        per_gpu = ______                      # 填空:优化器状态分片
    elif stage == 2:
        per_gpu = ______                      # 填空:优化器状态 + 梯度分片
    else:
        per_gpu = ______                      # 填空:三者全分片
    return per_gpu

def zero_communication_volume(num_params: int, stage: int) -> int:
    """
    每训练步每卡通信量(数值个数)。

    ZeRO-1/2: reduce-scatter(Ψ) + all-gather(Ψ) = 2Ψ
    ZeRO-3:   forward all-gather(Ψ) + backward all-gather(Ψ)
              + reduce-scatter(Ψ) = 3Ψ
    """
    if stage in (1, 2):
        return ______
    if stage == 3:
        return ______
    if stage == 0:
        return 2 * num_params      # 朴素 DP:一次全量 all-reduce ≈ 2Ψ
    raise ValueError("stage must be 0..3")

def make_table():
    """生成 7B 模型各 DP 度下的每卡静态显存表(GB)。"""
    P = 7_000_000_000
    print(f"{'dp':>4} {'Z1 GB':>8} {'Z2 GB':>8} {'Z3 GB':>8} {'comm 2Ψ/3Ψ (G)':>16}")
    for dp in (1, 8, 64):
        z1 = zero_memory_per_gpu(P, dp, 1) / 1e9
        z2 = zero_memory_per_gpu(P, dp, 2) / 1e9
        z3 = zero_memory_per_gpu(P, dp, 3) / 1e9
        comm = zero_communication_volume(P, 3) / 1e9
        print(f"{dp:>4} {z1:>8.1f} {z2:>8.1f} {z3:>8.1f} {comm:>16.1f}")

if __name__ == "__main__":
    make_table()
    # 交叉验证:dp=1 时三档必须相等
    P = 1_000_000
    assert zero_memory_per_gpu(P, 1, 1) == zero_memory_per_gpu(P, 1, 2) == zero_memory_per_gpu(P, 1, 3)
    print("dp=1 时三档相等 ✓")
```
## 三个问答题
### Q1
为什么 ZeRO 不能分片激活?请从"冗余"的定义出发解释。既然不能分片激活,训练超长序列时 ZeRO-3 会把内存瓶颈留在哪里?第 2 课的哪些技术与它正交?
### Q2
ZeRO-1 为什么把朴素 DP 的一次 all-reduce 换成 reduce-scatter + all-gather,而总通信量不变(都是 2Ψ)?"reduce-scatter 比 all-reduce 快两倍"在这里意味着什么?ZeRO-2 相比 ZeRO-1 又省了什么、通信为什么不变?
### Q3
ZeRO-3 的 3Ψ 通信量由哪三部分组成?prefetch 为什么能隐藏其中两部分?为什么 DP 规模超过约 512 后这套隐藏会失效?从分布式底层架构与系统工程角度,对比 PyTorch FSDP1(FlatParameter 包装器)与 FSDP2(DTensor 逐参数分片 `fully_shard`)在执行通信隐藏与配合 `torch.compile` 时的本质差异。
## 检查与通过标准
总分 10 分:代码正确 4 分(三档公式、FP32 累积分支、通信量、dp=1 交叉验证)、三题各 2 分、通过线 8 分。
一票否决项:
- 把 ZeRO 各档的分片对象搞错(如 ZeRO-2 分片了参数)。
- 说 ZeRO-3 激活也被分片。
- 通信量算错(不知道 2Ψ/3Ψ 从哪来)。
- 认为 ZeRO-3 的 N_d→∞ 可以把总显存(含激活与运行时)降到任意低。
- 混淆 FSDP1 与 FSDP2 的底层抽象(如误认为 FSDP2 仍在使用 FlatParameter 一维拼凑或 Module Wrapper 侵入式包装)。
::: {.callout-tip collapse="true" title="💡 点击展开参考答案与详细代码实现" icon="false"}
## 参考答案(仅 answer 分支)
先完成题目再核对;核对后必须解释关键公式,并改一个规模重新计算。
```{python}
#| course_role: solution
def zero_memory_per_gpu(
    num_params: int,
    dp: int,
    stage: int,                     # 0=朴素DP, 1, 2, 3
    k: int = 12,                    # Adam 混合精度优化器状态乘数(4 master + 4 m + 4 v)
    fp32_grad_accum: bool = False,
) -> float:
    """
    返回每个 GPU 的静态显存(bytes)。

    公式(BF16 参数/梯度 + FP32 master weights + FP32 Adam 状态):
        ZeRO-0: 2Ψ + 2Ψ + kΨ
        ZeRO-1: 2Ψ + 2Ψ + kΨ/dp
        ZeRO-2: 2Ψ + (2Ψ + kΨ)/dp
        ZeRO-3: (2Ψ + 2Ψ + kΨ)/dp
    可选 FP32 梯度累积:
        ZeRO-1 的梯度不分片,额外加 4Ψ;
        ZeRO-2/3 梯度分片,额外加 4Ψ/dp。
    """
    if num_params <= 0 or dp <= 0:
        raise ValueError("num_params and dp must be positive")
    if stage not in (0, 1, 2, 3):
        raise ValueError("stage must be 0..3")

    params_bf16 = 2 * num_params
    grads_bf16 = 2 * num_params
    opt_fp32 = k * num_params

    extra = 0.0
    if fp32_grad_accum:
        extra = 4 * num_params if stage <= 1 else 4 * num_params / dp

    if stage == 0:
        per_gpu = params_bf16 + grads_bf16 + opt_fp32 + extra
    elif stage == 1:
        per_gpu = params_bf16 + grads_bf16 + opt_fp32 / dp + extra                      # 填空:优化器状态分片
    elif stage == 2:
        per_gpu = params_bf16 + (grads_bf16 + opt_fp32) / dp + extra                      # 填空:优化器状态 + 梯度分片
    else:
        per_gpu = (params_bf16 + grads_bf16 + opt_fp32) / dp + extra                      # 填空:三者全分片
    return per_gpu

def zero_communication_volume(num_params: int, stage: int) -> int:
    """
    每训练步每卡通信量(数值个数)。

    ZeRO-1/2: reduce-scatter(Ψ) + all-gather(Ψ) = 2Ψ
    ZeRO-3:   forward all-gather(Ψ) + backward all-gather(Ψ)
              + reduce-scatter(Ψ) = 3Ψ
    """
    if stage in (1, 2):
        return 2 * num_params
    if stage == 3:
        return 3 * num_params
    if stage == 0:
        return 2 * num_params      # 朴素 DP:一次全量 all-reduce ≈ 2Ψ
    raise ValueError("stage must be 0..3")

def make_table():
    """生成 7B 模型各 DP 度下的每卡静态显存表(GB)。"""
    P = 7_000_000_000
    print(f"{'dp':>4} {'Z1 GB':>8} {'Z2 GB':>8} {'Z3 GB':>8} {'comm 2Ψ/3Ψ (G)':>16}")
    for dp in (1, 8, 64):
        z1 = zero_memory_per_gpu(P, dp, 1) / 1e9
        z2 = zero_memory_per_gpu(P, dp, 2) / 1e9
        z3 = zero_memory_per_gpu(P, dp, 3) / 1e9
        comm = zero_communication_volume(P, 3) / 1e9
        print(f"{dp:>4} {z1:>8.1f} {z2:>8.1f} {z3:>8.1f} {comm:>16.1f}")

if __name__ == "__main__":
    make_table()
    # 交叉验证:dp=1 时三档必须相等
    P = 1_000_000
    assert zero_memory_per_gpu(P, 1, 1) == zero_memory_per_gpu(P, 1, 2) == zero_memory_per_gpu(P, 1, 3)
    print("dp=1 时三档相等 ✓")
```
## 补全后的代码(关键填空处)
```python
if stage == 0:
        per_gpu = params_bf16 + grads_bf16 + opt_fp32 + extra
    elif stage == 1:
        per_gpu = params_bf16 + grads_bf16 + opt_fp32 / dp + extra
    elif stage == 2:
        per_gpu = params_bf16 + (grads_bf16 + opt_fp32) / dp + extra
    else:
        per_gpu = (params_bf16 + grads_bf16 + opt_fp32) / dp + extra
```
通信量:`2 * num_params`(stage 1/2);`3 * num_params`(stage 3)。
输出表(7B、k=12、无 FP32 梯度累积):
```python
dp   Z1 GB    Z2 GB    Z3 GB   comm 2Ψ/3Ψ (G)
   1    112.0    112.0    112.0             21.0
   8     38.5     26.2     14.0             21.0
  64     29.3     15.5      1.8             21.0
```
## 三个问答题要点
### Q1
- 冗余定义:ZeRO 消除的是"跨 DP 副本重复存储的相同数据"。激活在 DP 各副本上是**不同的**(不同 micro-batch),没有冗余可消除;
- 后果:ZeRO-3 之后内存瓶颈留在激活上 → 长序列需要第 2 课的重计算/梯度累积 + 第 6/8 课的 TP/CP;
- 正交性:ZeRO(管参数/梯度/优化器状态)× 重计算/TP/CP(管激活)可以叠加。
### Q2
- 正确性:优化 step 只需要自己的 1/N_d 梯度分片 → 用 reduce-scatter(每卡只留所需分片,通信量 K)替代 all-reduce(每卡全量,通信量 2K);
- 参数同步:优化后各卡持有不同的 1/N_d 新参数 → all-gather 补全;
- 总量:K + K = 2K,与 all-reduce 相同——"通信没变多,内存省了";
- ZeRO-2:梯度也分片 → 每卡只需存 1/N_d 梯度;reduce-scatter 后立刻释放其余分片;不做梯度累积时通信与 ZeRO-1 相同(都是 RS+AG=2Ψ);开启梯度累积后 ZeRO-2 每个 micro-batch 都要 reduce-scatter,通信次数多于 ZeRO-1(详见第 3 节)。
### Q3
- 3Ψ = 前向逐层 all-gather 参数(Ψ)+ 反向再次 all-gather(Ψ,用完即弃)+ reduce-scatter 梯度(Ψ);
- prefetch:算第 n 层时提前 all-gather 第 n+1 层参数(前向)/第 n−1 层(反向),把通信藏进计算;
- 失效条件:DP 太大 → 每步 all-gather 数据量相对单层计算时间过大、且 ring latency 累积 → 隐藏窗口装不下;
- "装得下"(内存分片)与"快"(通信能否隐藏)是两回事:ZeRO-3 在 512+ 卡上能装但效率掉;
- **FSDP1 vs FSDP2 通信隐藏与 `torch.compile` 协同差异**:
- **FSDP1**:依赖 Module Wrapper 和一维 `FlatParameter`,通信靠 Python 运行时 hook 启发式发射到单独 CUDA Stream,前向/反向中动态 slice 重塑并替换 `param.data`。这种原地对象变异直接打破 TorchDynamo 的静态追踪假设,引发频繁的 **Graph Break**,导致编译器无法跨层融合算子,且 Stream 并发容易出现竞态或显存峰值不可控;
- **FSDP2**:采用 Composable `fully_shard` 搭配原生多维 `DTensor`,完全保留 Module 原生树结构与参数多维形状。集合通信算子(All-Gather / Reduce-Scatter)作为显式 First-Class IR 节点内嵌在 AOTAutograd 导出的计算图中。TorchDynamo 实现 **零 Graph Break 全图编译**,编译器后端 Inductor 可在全图拓扑排序阶段全局规划异步通信节点的发射时机,实现编译器级确定的通信与计算流水线重叠。
## 通过要点
- k=12 的构成:4(master)+ 4(m)+ 4(v);FP32 梯度累积在 Z2/Z3 是 4Ψ/N_d、在 Z1 是 4Ψ。
- FSDP 是 ZeRO-3 在 PyTorch 工业界的核心落地;ZeRO 只沿 DP 维分片。
- FSDP1(FlatParameter + Module Wrapper 侵入式)存在图中断与 2D 并行适配难的缺陷;FSDP2(DTensor + `fully_shard` 函数式)原生实现零 Graph Break 全图编译,支持 DeviceMesh 正交 2D 并行(TP+FSDP2)。
## 官方主参考
- [Ultra-Scale Playbook](https://huggingface.co/spaces/nanotron/ultrascale-playbook)
- [PyTorch Distributed Documentation](https://pytorch.org/docs/stable/distributed.html)
- [PyTorch FSDP2 (fully_shard) Official Tutorial & Architecture](https://pytorch.org/tutorials/intermediate/FSDP_tutorial.html)
- [PyTorch DTensor & 2D DeviceMesh Parallelism Design](https://pytorch.org/docs/stable/distributed.tensor.parallel.html)
:::
::: {.course-pagination}
[**← 上一课**<br>第 4 课:数据并行 DP 与 DDP](lesson04.qmd){.pagination-link .pagination-prev}
[**下一课 →**<br>第 6 课:张量并行 TP](lesson06.qmd){.pagination-link .pagination-next}
:::
