本课目标与完成标准
学完后你应能:为 shape/dtype/SM 选择候选 kernel,用正确 benchmark 方法而非单次计时做决策。
通过必须同时满足:
- 独立补齐本课唯一的代码填空题,并通过给定检查;
- 三个问答题均说明因果链,而不是只报术语;
- 能指出至少一个正确性边界和一个性能取舍;
- 总分不低于 8/10,且没有一票否决级概念错误。
前置关系
- 课程前置:CUDA 线程模型、GEMM、C++ 模板基础
- 本课在路线中的作用:生产 CUTLASS 集成通常由多个 kernel specialization 与 dispatch 组成;不存在对所有 shape 都最佳的单一 tile。
核心心智模型
1. 它是什么,解决什么问题
Kernel 组合、自适应分发与性能剖析(Kernel Specialization, Dispatch & Profiling) 是将 CUTLASS 高性能模板库工程化落地到生产级推理引擎(如 TensorRT-LLM、vLLM)中的“最后一公里”。
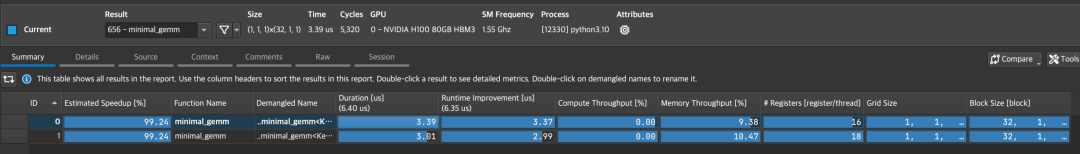
“不存在放之四海皆准的单一最优 Tile”(结合图 8-1 与图 8-2): - 形状多样性带来的性能撕裂: - 在大模型训练与 Prefill 阶段, 均为数千的大矩阵,大分块(如 )配合 4 阶段流水能打满全部 SM; - 但在 LLM 生成解码阶段(Decode GEMV),Token 数 。若依然沿用 的大配置,M 维度只有 1 个 Tile。网格只剩 N 方向的 ceil(N/N_tile) 个 CTA(如 N=4096、N_tile=128 时为 32 个),且每个 CTA 的 256 行里只有 1 行有效,Tensor Core 利用率不足 1%。 - 分发中枢(Dispatch Engine,图 8-2):
图 8-2:CUTLASS Kernel 动态配置选型与分发调度流程
必须根据运行时动态传入的张量尺寸 、数据类型(FP16/BF16/FP8)与硬件架构(SM80/SM90),通过预先调优的启发式分桶表格(Shape Bucketing),动态路由(Dispatch)到最匹配的模板特化实例; - NCU 深度剖析(图 8-1):
图 8-1:Nsight Compute (NCU) 算子性能分析概览界面
利用 Nsight Compute 的硬件性能计数器,精准定位算子是处于 Memory-Bound、Compute-Bound 还是被发射延迟阻塞,建立科学的调优基线。
2. 它如何工作(结合图 8-1 与图 8-2)
生产级算子选型与分发流水线包含四个严密的阶段:
- 硬约束静态过滤(Constraint Filtering):
- 检查硬件架构计算能力(如 FP8 Tensor Core 需要 SM89 Ada 或 SM90+ Hopper);
- 检查基准显存指针地址是否满足 16 字节物理对齐(决定是否可开启 128-bit 向量化加载);
- 检查收缩维度 是否满足 MMA Atom 的整除性约束。
- 启发式分桶路由(Shape Bucketing Dispatch,图 8-2):
- 建立几何分桶表:将高度动态的连续输入维度离散化映射到不同的工作模式:
- (Decode 阶段):路由至 Split-K 或小 高度展开的 GEMV 特化 Kernel;
- :路由至小 Tile、深流水线的低延迟 Kernel;
- (Prefill / Training 阶段):路由至大 Tile、高吞吐的满载 GEMM Kernel。
- 工作区分配与异步启动(Workspace Allocation & Launch):
- 为选定的特化 Kernel 准备运行时参数结构体与 Shared Memory / Split-K 临时中间张量工作区(Workspace);
- 将参数下发到指定的 CUDA Stream 中异步发射。
- 性能基准评测闭环(Profiling Feedback Loop,图 8-1):
- 在生产上线前通过离线 Autotuning 脚本遍历参数网格,利用 NCU 提取 Roofline 利用率,反向填充最优分发决策表。
3. 正确性条件与常见误区
- “单次运行计时”的致命基准偏差:
- 致命误区:在循环外打两个 CUDA Event 仅测单次耗时便选定最优 Kernel;
- 底层硬件现实:首次运行包含 GPU 驱动冷启动、时钟频率爬坡(P-State 提频延迟)、编译期 JIT 链接与 L2 Cache 冷加载;单次测量结果极度失真,根本不具备统计置信度;
- 浮点数值参考对验的缺失(Silent Bug Hazard):
- 速度最快的候选 Kernel 很可能存在边界掩码未生效、收缩尾块未清零的致命 Bug。测试框架必须先将候选 Kernel 的输出与 FP32 纯精度 CPU 参考实现按严格公差(
rtol/atol)对验通过,才能将其纳入候选池。
4. 性能与工程取舍(精确匹配 vs. 几何分桶)
- 精确形状表(Exact Shape Table):
- 优点:对固定的特定尺寸(如 )能挖掘出最后 1%~2% 的极限算力;
- 缺点:在 LLM 推理场景中,Batch 和上下文长度实时剧烈变动。若为每个出现的具体尺寸都编译一个特化 Kernel,会导致二进制库体积暴涨数 GB,编译耗时数小时,且未见过的尺寸直接命中降级冷路径;
- 几何分桶表(Geometric Shape Bucketing):
- 优点:仅保留少数几个典型分界点(如 ),编译产物紧凑可控,覆盖全部动态场景;
- 缺点:在某些非典型边界尺寸上,可能比极限专用定制落后 3%~5% 的峰值吞吐,是现代工业级系统平衡维护代价与极致性能的黄金解。
具体演示:Roofline 理论极限执行时间测算
考虑输入矩阵乘法计算量 ,数据读写最低显存搬运量 :
设目标 GPU 的 Tensor Core 理论算力峰值 ;
显存物理带宽 ;
计算时间下界:
访存时间下界:
Roofline 理想执行时间:
调优指导:该算子受限于显存带宽(Memory-Bound)。若 profiling 实测为 8 ms,优化空间在访存流水和 L2 命中率;若优化 Tensor Core 发射,即使算力利用率由 50% 提升到 100%,耗时绝不可能低于 5.0 ms 的物理显存红线。
实践任务:唯一代码填空题
补齐受带宽和计算双重上限约束的 roofline 时间。
规则:只能修改 TODO/______ 所在位置;不要删除断言或放宽误差。代码注释说明了每个边界条件。
Code
def roofline_seconds(flops, bytes_moved, peak_flops, bandwidth):
    """理想时间取计算时间与内存时间的较大者。"""
    # TODO:只补齐下面这个表达式。
    return ______

assert roofline_seconds(100,200,100,100) == 2
assert roofline_seconds(200,100,100,100) == 2
检查方法
运行本单元格;所有 assert 必须通过。另手工构造一个边界输入,解释预期结果。
提交时请给出:补齐后的代码、实际运行输出(环境不可用时注明“仅静态审查”)以及对失败用例的解释。
Q1
不要背定义:请从输入、状态变化和输出三个阶段解释“Kernel 组合、Dispatch 与 Profiling”的工作机制。
你的答案:
Q2
只用 CUDA Event 测一次就选择 kernel,遗漏了哪些噪声与正确性风险?
你的答案:
Q3
dispatch 表应该按精确 shape 还是 shape bucket?说明维护与性能取舍。
你的答案:
评分与通过规则
- 代码 4 分:正常输入 2 分,边界输入 1 分,解释实现 1 分;
- Q1~Q3 各 2 分;
- 一票否决:结果碰巧正确但核心因果链错误、删除边界检查、把未运行结果说成实测。
需要提示时按四级机制请求:概念区域 → 具体方向 → 关键局部 → 完整答案。
参考答案(仅 answer 分支)
先完成题目再核对。即使代码一致,也要能解释关键步骤,并尝试更换一个输入规模。
Code
def roofline_seconds(flops, bytes_moved, peak_flops, bandwidth):
    """理想时间取计算时间与内存时间的较大者。"""
    # 参考实现:表达式直接对应上文不变量。
    return max(flops / peak_flops, bytes_moved / bandwidth)

assert roofline_seconds(100,200,100,100) == 2
assert roofline_seconds(200,100,100,100) == 2
Q1 参考答案
- 输入阶段(Dynamic Metadata Ingestion & Hardware Filtering):
- 调度器接收上层框架传入的运行时动态参数:矩阵几何形状 、数据类型、Leading Dimension 步长以及目标 GPU 架构信息;
- 过滤硬性约束条件(检查物理指针对齐性、数据类型是否被当前架构原生支持、共享内存上限是否超标),迅速剔除不合法的候选 Kernel;
- 状态变化阶段(Heuristic Dispatch & Workspace Provisioning):
- 运行时引擎查询预先经过离线 Profiling 优化的启发式分桶表(Shape Bucket Dispatch Table),锁定该尺寸下理论算术强度与硬件占用率综合最优的特化模板配置(包括 CTA Tile 尺寸、Warp 编排网格与流水线 Stage 深度);
- 初始化运行时参数,按需为 Split-K 或异步通信分配专用的中间张量显存工作区(Workspace);
- 输出阶段(Stream Dispatch & Profiling Closed Loop):
- 将选定的特化 Kernel 打包为可执行配置,推入当前激活的 CUDA Stream 中全速并发执行;
- 在性能分析阶段,通过 Nsight Compute (NCU) 提取实际达成的 TFLOPS、DRAM 吞吐与 Roofline 极限,将实测数据反馈回分发决策数据库,闭环修正启发式选型规则。
Q2 参考答案
若仅仅通过一对 CUDA Event 执行单次计时就盲目做选型决策,会遗漏严重的硬件微架构物理噪声与不可逆的数值正确性风险:
- 微架构物理噪声导致的巨大基准偏差:
- GPU 功耗与时钟频率爬坡(P-State Clock Boosting):GPU 在空闲时会自动处于低频省电状态(如 500 MHz)。当新 Kernel 发射时,硬件稳压单元需要耗费数毫秒时间将主频拉升至峰值 Boost 频率(1800~2000 MHz)。单次测量测到的实际上是“频率爬坡延迟”,完全不能代表稳态吞吐;
- 冷缓存击穿(Cold Cache Penalty):首次运行必须承担 HBM 页表填充(TLB Walk)、代码段指令加载(I-Cache Miss)以及 L2 Cache 冷失效开销;而稳态生产中权重张量往往享有极高的 L2 缓存命中率;
- CPU 驱动端发射抖动:驱动程序构建 Launch 参数和分配显存页的抖动会被误算进 GPU 执行时间中;
- 标准实践:必须先执行 次 Warmup 消除冷启动效应,固定 GPU 核心时钟频率(
nvidia-smi -lgc),随后循环测试数十次取中位数(Median/P50),并清空 L2 Cache(Cache Flush)以保证可复现性;
- 完全被忽略的数值正确性灾难(Silent Bug Risk):
- “跑得最快的 Kernel”极有可能是因为内部发生了未捕获的边界越界、谓词掩码失效,或者提前
return 导致跳过了大部分实际计算。
- 单次测时根本不检查输出数据;如果选出了一个能够以 0.1 ms 极速跑完、但输出全是 0 或 NaN 的“幻影 Kernel”,会导致线上模型生成崩溃。基准评测必须强制绑定数值公差校验。
Q3 参考答案
在构建 Dispatch 决策表时,必须采用几何分桶(Shape Bucketing),而非精确形状匹配(Exact Shape Matching),这是权衡工程维护代价与性能天花板后的必然选择:
- 精确形状表(Exact Shape Table)的致命弊端:
- 维度爆炸与维护失控:在大模型动态推理中,Batch 大小、Prompt 长度与解码生成步数实时变动, 的组合数高达数百万种。为每一个精确尺寸生成特化实例会导致编译出来的动态链接库二进制体积暴涨数 GB,编译器构建耗时数十小时;
- 命中率极低:一旦用户输入了一个未曾预先 Profiling 过的全新序列长度(如 ),精确表直接 Miss,只能悲观降级到最保守的兜底通用 Kernel,性能断崖式下跌;
- 几何分桶表(Shape Bucketing)的巨大工程优势:
- 离散化聚类:将高度动态的输入维度按几何倍率划分为少数几个离散工作区间(例如将 分桶为: 代表 Decode、$ [2, 16]$ 代表小批量推断、 代表中型序列、 代表高吞吐 Prefill);
- 编译体积小、泛化能力极强:只需维护 10~20 个精心打磨的核心模板特化,二进制体积控制在几十 MB 以内,且任意输入形状均能 100% 命中行为可预期的最优分桶;
- 性能代价极小:现代 GPU 的 SM 调度器对一定范围内的形状波动具有很强的容忍度。相比穷举精确微调,分桶方案仅牺牲了不到 2%~5% 的极限性能,却换来了工业级的系统健壮性、可解释性与敏捷部署能力。
参考资料
资料用于建立事实基线;面试回答仍需用自己的语言组织。